L'agence
WanadevStudio
Complexité cognitive des algorithmes via le référentiel SonarQube
Il y a 17 heures
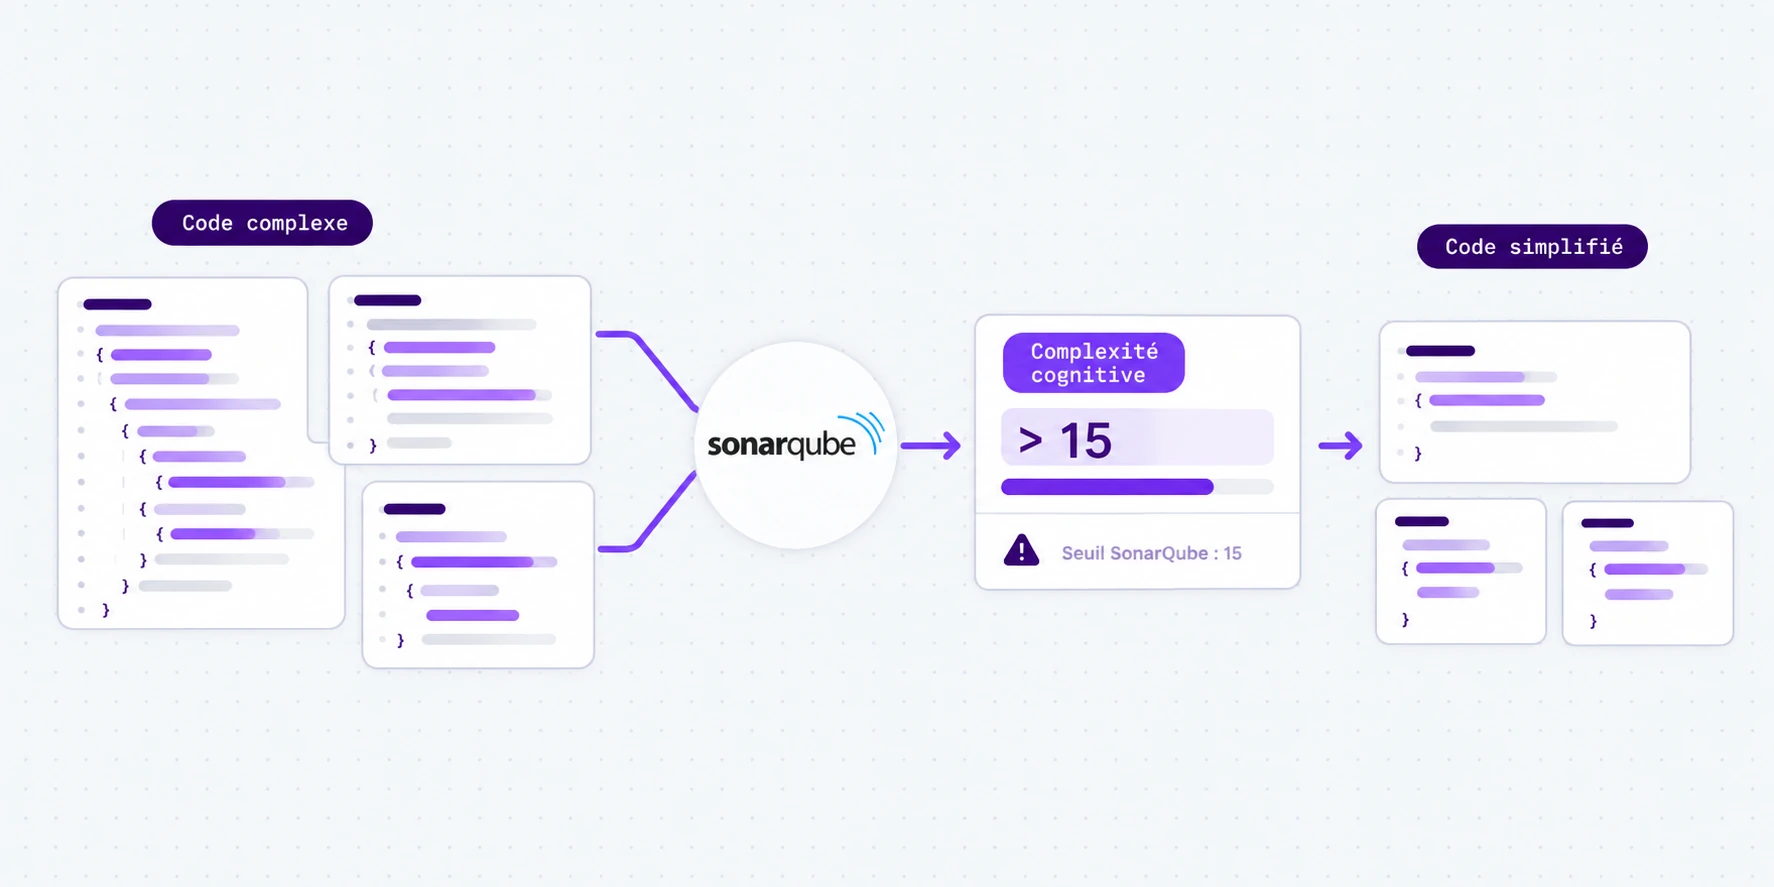
Découvrez la complexité cognitive selon SonarQube : comment mesurer, réduire et maîtriser la lisibilité de vos fonctions avec des exemples concrets.
Sommaire
- Introduction : Qu’est-ce que la complexité cognitive ?
- Principe
- Exemples et bonnes pratiques
- Bénéfices
- Conclusion
- Liens utiles
Introduction : Qu’est-ce que la complexité cognitive ?
Le terme de “complexité cognitive” désigne le niveau de difficulté de compréhension de quelque chose. Dans notre cas, on parlera de complexité de lecture et de compréhension d’un algorithme, pour un humain. On différencie donc cela de la complexité dans le sens mathématique : on ne parlera pas ici de temps d’exécution d’algorithmes, de complexités linéaires, polynomiales, etc ; c’est un beau sujet mais pas celui que nous allons voir ici 😉.
Soulignons le terme “cognitive” : la complexité cognitive est une métrique étudiée, tout en restant un indicateur. Elle ne repose pas sur un concept mathématique, mais plus sur une estimation logique empirique. Il s’agit d’une mesure de la “compréhensibilité”, ce qui n’est pas nécessairement évident à décrire et peut être subjectif : cela dépend des personnes, de la manière de réfléchir, des habitudes… c’est un référentiel possible pour l’étude de la complexité d’écriture d’algorithmes, mais ce n’est pas le seul, et il n’est pas absolu, même s’il est tout à fait clair et cohérent. Nous prendrons ici comme référence l’étude de SonarQube, système automatique d’analyse statique de code pour aider à l’écriture de celui-ci, identifier de potentiels bugs, et repérer de mauvaises pratiques.
Principe
L’étude de la complexité cognitive d’un algorithme peut se faire à l’échelle des fonctions : on détermine quel est le degré de complexité d’une fonction dans son ensemble (c’est ce que fait SonarQube, les analyses se font par fonction, de manière cloisonnée). Les règles qui déterminent cette complexité restent simples, ce qui permet d’une part d’en tirer un ensemble de bonnes pratiques assez faciles à mettre en place, et d’autre part de pouvoir mesurer cette complexité “à la main”, en tout cas en avoir un aperçu rapide, en même temps qu’on est en train de programmer. Ces règles tendent à traduire en quelque sorte les étapes de lecture humaine d’un algorithme : on verra que la complexité cognitive augmente avec le nombre de conditions et d’imbrications, ce qui semble assez logique. Dans l’idée, en fonction du code d’un algorithme, un score va être attribué pour représenter sa complexité.
Ce score peut être utilisé de manière simple avec un seuil pour identifier quelles sont les fonctions considérées comme trop complexes, et voir à quels endroits de ces fonctions le score s’incrémente beaucoup, signe que le code pourrait être simplifié en le remaniant. Avec ce système, on ne considère pas que la complexité augmente avec des appels de fonctions séparées (sauf pour des appels récursifs), on ne cherche pas à savoir ce que font ces fonctions ou si elles sont elles-mêmes trop complexes. Ainsi, dans le cas où la complexité a déjà été minimisée, un score au-dessus du seuil indique à quel moment on devrait avoir un redécoupage de l’algorithme.
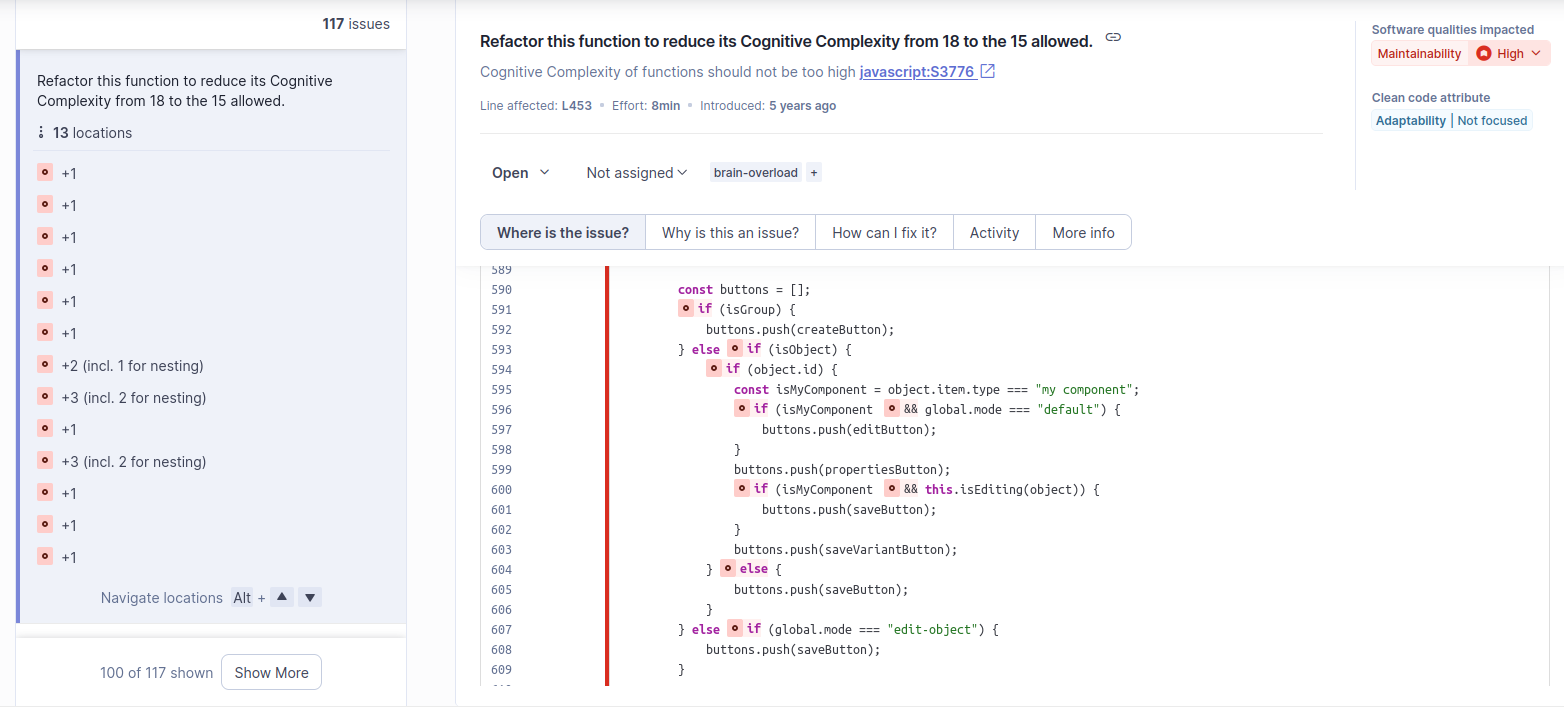
Globalement, les instructions de boucle ou conditionnelles (for, while, if-else-if, switch, catch, ternaires…) qui “cassent” le flux de lecture vont incrémenter le compteur de complexité cognitive ; et chaque imbrication va ajouter du poids à ces incrémentations : plus on se trouve dans du code imbriqué, plus c’est difficile de garder tout le contexte de la fonction en tête jusqu’à ce point d’imbrication. Ainsi, plus on est imbriqué, plus une boucle ou une condition va ajouter de la complexité. Une bonne pratique évidente au vu de ce calcul est de limiter au plus les imbrications1, ce qui incite à plus de découpage.
À titre indicatif, la valeur seuil par défaut utilisée dans SonarQube à partir de laquelle une fonction est considérée comme trop complexe est de 152.
1. D’ailleurs, SonarQube mentionne aussi la règle “Refactor this code to not nest functions more than 4 levels deep.” concernant le code trop imbriqué.
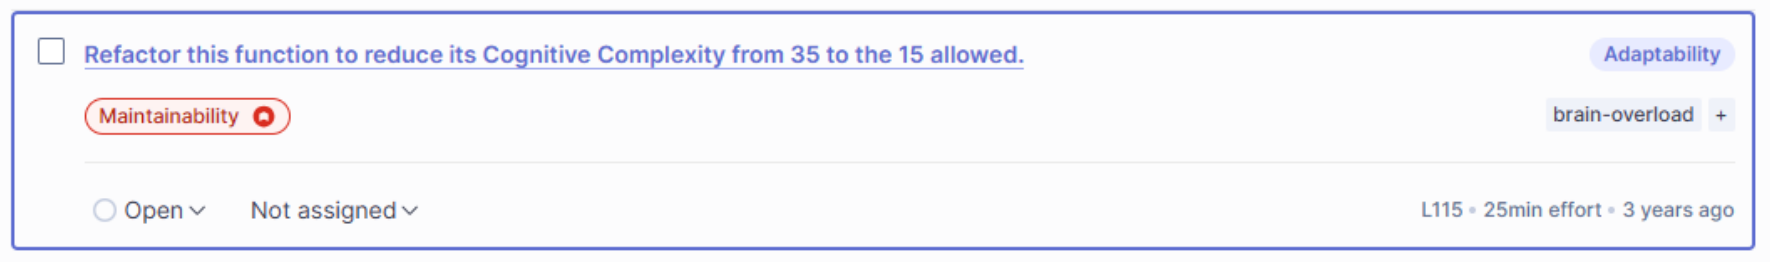
2. Dans SonarQube, la règle sur la complexité cognitive est située dans la partie Software Quality: "Maintainability" - "High" (c’est également le cas pour la règle des fonctions imbriquées précédemment citée). Elle apparaît avec le message “Refactor this function to reduce its Cognitive Complexity from xx to the 15 allowed.”
Exemples et bonnes pratiques
Tout d’abord, allons sur SonarQube pour voir comment la règle apparaît dans la liste des items :
Et voici comment se présente le détail de la règle (avec le calcul du score qui est détaillé et qui aide à repérer les endroits les plus problématiques) :
On peut déduire de ce calcul et de la partie précédente un ensemble de bonnes pratiques à avoir lorsqu’on écrit du code, parmi lesquelles on peut citer non exhaustivement :
- Limiter le nombre d’imbrications au maximum. Par exemple, privilégier des early return plutôt qu’un grand if englobant (qui à chaque condition/boucle à l’intérieur, va augmenter la complexité cognitive avec un facteur supplémentaire)
|
|
Complexité de 6 à gauche contre 3 à droite
- Privilégier l’usage de switch/case plutôt que des enchaînements longs de if/else/if… quand c’est possible : ainsi on aura un seul incrément de score pour l’ensemble du switch/case plutôt que un par condition de if (il y a des fois où ça réduit beaucoup la complexité et en rendant le code bien plus clair). Notons toutefois, si vous voulez tout savoir, qu’il y a quand même une limitation par défaut à 30 cases dans un switch au bout de laquelle SonarQube déclenche un warning3)
|
|
Complexité de 3 à gauche et 1 à droite
- Bien découper son code pour éviter des fonctions trop longues et avoir un aperçu logique assez simple des algorithmes (je renvoie également pour ce point-là à la programmation par intention ainsi qu’au test-driven development (TDD), qui permettent d’avoir un découpage pratique à lire et à tester). Dans le même esprit, limiter les responsabilités permet d’éviter que des fonctions ou un fichier fassent plein de choses différentes, en ayant une architecture plus carrée.
   if (data.truc && !data.machin) {
       data.remove("bidule");
   } else if (data.chose) {
       delete data.autreChose;
   }

   data.new = ! (data.old || data.oldOld);

   for (const key in data) {
       ... // on va arrêter là pour cet exemple naze hein
   }
cleanData(data);
updateData(data);
processData(data);
logData(data);
jeSaisPasQuoi(data);Exemple moche pour illustrer qu’une longue succession de bouts de code comme à gauche est plus reloue à lire et à comprendre qu’une succession d’appels de fonctions nommées
- Dans certains cas, on peut procéder à un découpage encore plus simple et précis, par exemple en extrayant les conditions complexes pour en faire une fonction séparée : cela pourra être réutilisé dans d’autres parties du code et, bien nommée, la fonction aidera à comprendre le code d’un seul coup
- Penser à quelques astuces d’écriture qui reviennent au même mais avec des conditions “sous-entendues” qui sont plus directes à comprendre4). On peut prendre comme exemple l’optional chain expression qui permet de simplifier une condition avec l’opérateur "?"5).
|
|
Pour chaque if, la complexité passe de 2 à 1
Cependant, la complexité cognitive reste un indicateur qui n’est pas parfait. En effet, une assignation, même un peu compliquée, ne casse pas le flux de lecture, donc n’incrémente pas le score. Mais selon les cas, on peut noter une légère complexification de la lecture, comme par exemple :
const orderedData = Object.values(this.data).sort((a, b) => a.layer - b.layer);où le sort a un peu le rôle d’une comparaison masquée. On peut donc voir cela comme une limitation au système de calcul de SonarQube.
3. Il s’agit de la règle “Reduce the number of non-empty switch cases from xx to at most 30.”
4. Ce qu’on appelle communément le “sucre syntaxique”.
5. Il s’agit même là d’une règle SonarQube à part entière: “Prefer using an optional chain expression instead, as it's more concise and easier to read”.
Bénéfices
On pourrait se demander si c’est “si grave” d’avoir des fonctions complexes, longues, etc, “du moment que ça marche”. Mais le gain est bien présent pour plusieurs raisons :
- En acquisition de bonnes pratiques diverses et variées
- Des morceaux de code anciens faits avec peu ou pas de méthodes restent problématiques sur des projets notamment longs ou conséquents, puisque, et c’est bien mentionné par SonarQube, cela rend plus long et difficile les évolutions ou le debug. C’est pour cela que les items de complexité cognitive sont mentionnés dans la catégorie “Maintainability” : ils impactent directement l’évolution du projet et sa difficulté à être maintenu (en termes d’effort : temps passé et complexité).
- En termes d’indicateurs de qualité, avoir un board SonarQube clean est toujours un plus, voire un avantage pour montrer que le travail effectué est qualitatif d’après des outils neutres et répandus. De plus, cela peut être utilisé comme une aide à la review et à la validation
- Également, on peut noter le côté “cercle vertueux” des bonnes pratiques, du découpage et de la clarté, donnant un code plus facile à tester en conséquence
Conclusion
L’outil de complexité cognitive est intéressant à plusieurs titres, d’abord parce qu’on peut l’utiliser comme un indicateur de qualité permettant de savoir si le code écrit est plus ou moins compréhensible, selon un référentiel commun utilisant des critères relativement neutres, et par conséquent avoir un aperçu de la complexité de maintenabilité et d’évolution du code. Aussi, le système de calcul du score étant relativement simple à comprendre, on peut déjà l’avoir en tête au moment d’écrire du code. De plus, l’intégrer au processus de développement permet d’identifier de potentielles mauvaises pratiques et d’améliorer la qualité de code écrit, encore plus en le combinant avec d’autres méthodologies de travail comme la programmation par intention et le TDD. 😉
Liens utiles
- Complexité d’algorithmes
- Complexité d’algorithmes (temps)
- Outil SonarQube d'analyse statique de code
- Publication SonarQube sur la complexité cognitive, par G. Ann Campbell (en anglais)
- Extension SonarQube for IDE (l’extension pouvant être gourmande en ressources, il peut être pratique selon votre machine d’utiliser ESLint en configurant les mêmes règles que SonarQube)
-
 Petit Mariage Entre Amis : bousculer la personnalisation print en ligne par l’édition 2D et 3D
Il y a 2 mois
Plongez dans les coulisses de notre collaboration avec Petit Mariage Entre Amis, référence des objets et papeterie personnalisés depuis 15 ans. Pour répondre à leurs ambitions, nos équipes ont imaginé un configurateur 2D/3D web flexible capable de gérer un gros volume de produits et templates. R&D, interconnexion technique et témoignages : Tim, Damien et Antoine vous racontent comment nous avons transformé une idée de départ en une solution robuste et industrialisée.
-
 Design to code : comment l'IA redéfinit les rôles entre design et développement
Il y a 3 mois
Chez un fournisseur de solutions 3D web, la collaboration entre designers et développeurs, c'est le cœur du réacteur. C'est aussi, soyons honnêtes, une source de friction chronique : des intentions créatives qui se perdent en chemin, des cycles de validation qui s'étirent, des allers-retours qui s'accumulent. Ce n'est la faute de personne. C'est la faute du processus. Depuis qu'on intègre l'IA dans le workflow des équipes avec lesquelles je travaille, ce processus a changé.
-
 Retour sur le Meet-up Python du 30 juin 2025
Il y a 1 an
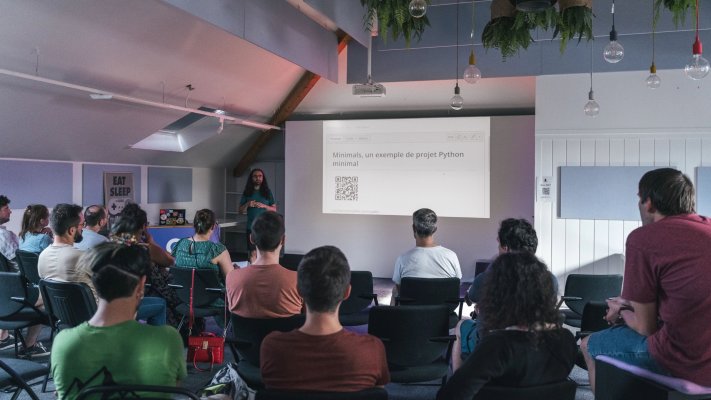
Ce lundi 30 juin 2025 nous accueillions la branche lyonnaise de l'AFPy dans nos locaux pour un meetup autour du langage Python. Malgré les fortes températures, une trentaine de personnes ont répondu présentes pour ce moment de convivialité et d'échange.
-
 Figma Make : enfin une passerelle prometteuse entre design et code grâce à l'IA
Il y a 1 an
Depuis quelques années, les outils d'IA pour générer des intégrations d'interfaces à partir de maquettes fleurissent. On en a testé plusieurs chez WanadevDigital : de Locofy à Uizard, en passant par Framer AI. Tous ont leurs qualités, mais jusqu’ici, il manquait un vrai pont stable entre les intentions du designer et la réalité du code front.
L’arrivée de Figma Make change la donne. Et si je devais résumer son impact en une phrase : ça fonctionne, et ça fonctionne pour tout le monde, designers, développeurs et intégrateurs !
-
 Maîtriser la traduction (i18n) dans un projet web - Partie 1 : Configurer proprement
Il y a 2 ans
Mettre en place l'internationalisation (i18n) dans un projet web peut sembler simple. Cependant, de nombreux projets se retrouvent avec des configurations de traduction mal gérées, difficiles à maintenir ou à faire évoluer à mesure que l'application grandit. Une stratégie i18n robuste est essentielle pour offrir une expérience utilisateur fluide dans plusieurs langues.
Je vous décris ici, les pratiques que nous avons établies chez Wanadev au fil des années d'expérience pour mettre en œuvre et gérer les traductions dans les projets Vue. Bien que les exemples soient spécifiques à Vue, la plupart de ces pratiques peuvent être appliquées à n'importe quel framework.
-
 Maîtriser la traduction (i18n) dans un projet web - Partie 2 : Conseils pour une localisation gérable et évolutive
Il y a 2 ans
Dans la partie 1, nous nous sommes concentrés sur la mise en place d'une base solide pour la gestion des traductions dans un projet Vue. Maintenant que votre système de traduction est opérationnel, il est temps d'examiner de plus près comment structurer, gérer et faire évoluer vos fichiers de traduction de manière efficace.
Cette partie couvrira les bonnes pratiques que nous utilisons chez Wanadev pour créer des clés de traduction maintenables, éviter les pièges courants et garantir que vos fichiers de traduction restent propres et évolutifs au fur et à mesure que votre projet grandit.