L'agence
WanadevStudio
Neural Shading en WebGL : Remplacer un shader par un réseau de neurones
Il y a 2 jours
Le neural shading consiste à remplacer un calcul trop lourd dans un shader par un petit réseau de neurones, entraîné à partir d'images de référence. NVIDIA et Microsoft poussent fort sur le sujet en 2026, surtout pour les cartes graphiques haut de gamme. J'ai voulu savoir si ça tenait dans une page web, sur un téléphone normal, et j'ai construit une démo WebGL avec un dragon en jade pour le vérifier.
Je suis tombé sur un article de Charles Grassi sur des nuages volumétriques neuronaux. Il prend son shader de nuages et remplace un seul calcul, la diffusion de la lumière à l'intérieur du nuage, par un petit réseau de neurones de deux couches de 16 neurones. Ce réseau est entraîné sur un path tracer. Résultat, l'éclairage du nuage reste correct quelle que soit la position du soleil, alors que l'approximation classique peut être jusqu'à 5 fois trop sombre ou 2 fois trop claire selon l'angle.
Ce qui m'a fait tiquer, c'est que je trouvais ça fun d'utiliser de "l'IA", et en même temps un peu overkill pour faire juste des ombres. Après, je me suis dit que quitte à consommer du GPU, autant vérifier ce qui donne le meilleur résultat : un réseau de neurones ou un calcul classique dans le shader.
Chez WanadevDigital, on fait de la 3D dans le navigateur. Ma question était donc simple : est-ce que ça marche aussi en WebGL, mais aussi sur mon téléphone ?
J'ai fait deux essais, d'abord une bougie, qui ne m'a pas convaincu, puis un dragon en jade, beaucoup plus parlant.
Le neural shading
Le neural shading, c'est remplacer un calcul trop lourd d'un shader par un petit réseau de neurones, entraîné à reproduire le bon résultat à partir d'images de référence. Ça sert surtout pour les effets de lumière qu'on ne sait pas calculer correctement en temps réel.
Dans un moteur temps réel, certains effets de lumière coûtent trop cher pour être calculés correctement à chaque image. Le subsurface scattering en fait partie : c'est ce qui rend le jade, la cire ou la peau lumineux de l'intérieur quand on les éclaire. Les moteurs s'en sortent avec des approximations rapides, plutôt justes dans les cas simples, mais qui décrochent dans d'autres, à contre-jour par exemple.
La référence pour faire mes calculs, c'est un path tracer comme Mitsuba, un outil des rendus de cinéma : il suit vraiment le trajet de la lumière dans la matière. Le résultat est juste, mais beaucoup trop lent pour du temps réel : dans mes tests, environ un quart d'heure pour une seule image.
Le neural shading se place entre les deux.
- On génère hors ligne beaucoup d'images avec un path tracer. C'est notre ground truth.
- On entraîne un petit réseau (un MLP) à prédire, pour chaque point de la surface, la lumière que donne le path tracer.
- On recopie ce réseau dans le fragment shader. Pour chaque pixel, il fait quelques centaines de multiplications et sort une couleur.
Le réseau ne remplace qu'un seul calcul du shader, celui qui coûte trop cher. Le reste du rendu ne change pas, et tout ça se branche sur un moteur existant sans réécrire toute notre pipeline de rendu.
À ne pas confondre avec le DLSS
Le DLSS de NVIDIA (et ses équivalents récents, FSR 4 chez AMD et PSSR chez Sony) est aussi un réseau de neurones, mais il travaille sur l'image finie, qu'il upscale ou débruite. On le trouve déjà dans la plupart des jeux récents. Le neural shading intervient plus tôt, dans le shader d'un matériau, avant que l'image existe. Le réseau est minuscule et ne sait faire qu'une seule chose.
D'où ça vient, et qui l'utilise
Le neural shading n'est pas né en 2026. Les premiers gros travaux datent de 2021 chez NVIDIA, et les premiers usages en production ont été rendus publics en 2025 chez NVIDIA, puis en 2026 chez Ubisoft.
| Date | Ce qui s'est passé | Qui |
|---|---|---|
| 2021 | Neural radiance cache, premier papier (SIGGRAPH) | NVIDIA |
| 2023 | Neural texture compression, premier papier (SIGGRAPH) | NVIDIA |
| 2024 | Neural materials compressés en BC6, décodés directement dans un shader (Eurographics) | Ubisoft La Forge |
| 2024 | Real-Time Neural Appearance Models, des matériaux de cinéma rendus en temps réel (SIGGRAPH) | NVIDIA |
| Mars 2025 | Le neural radiance cache est intégré à RTX Remix, présenté comme le premier neural shader, avec la démo Half-Life 2 RTX | NVIDIA |
| 2025 et 2026 | Les cooperative vectors (preview en 2025), puis l'API Linear Algebra du Shader Model 6.10 (preview en avril 2026), arrivent dans DirectX pour exécuter ces réseaux sur les tensor cores | Microsoft, NVIDIA |
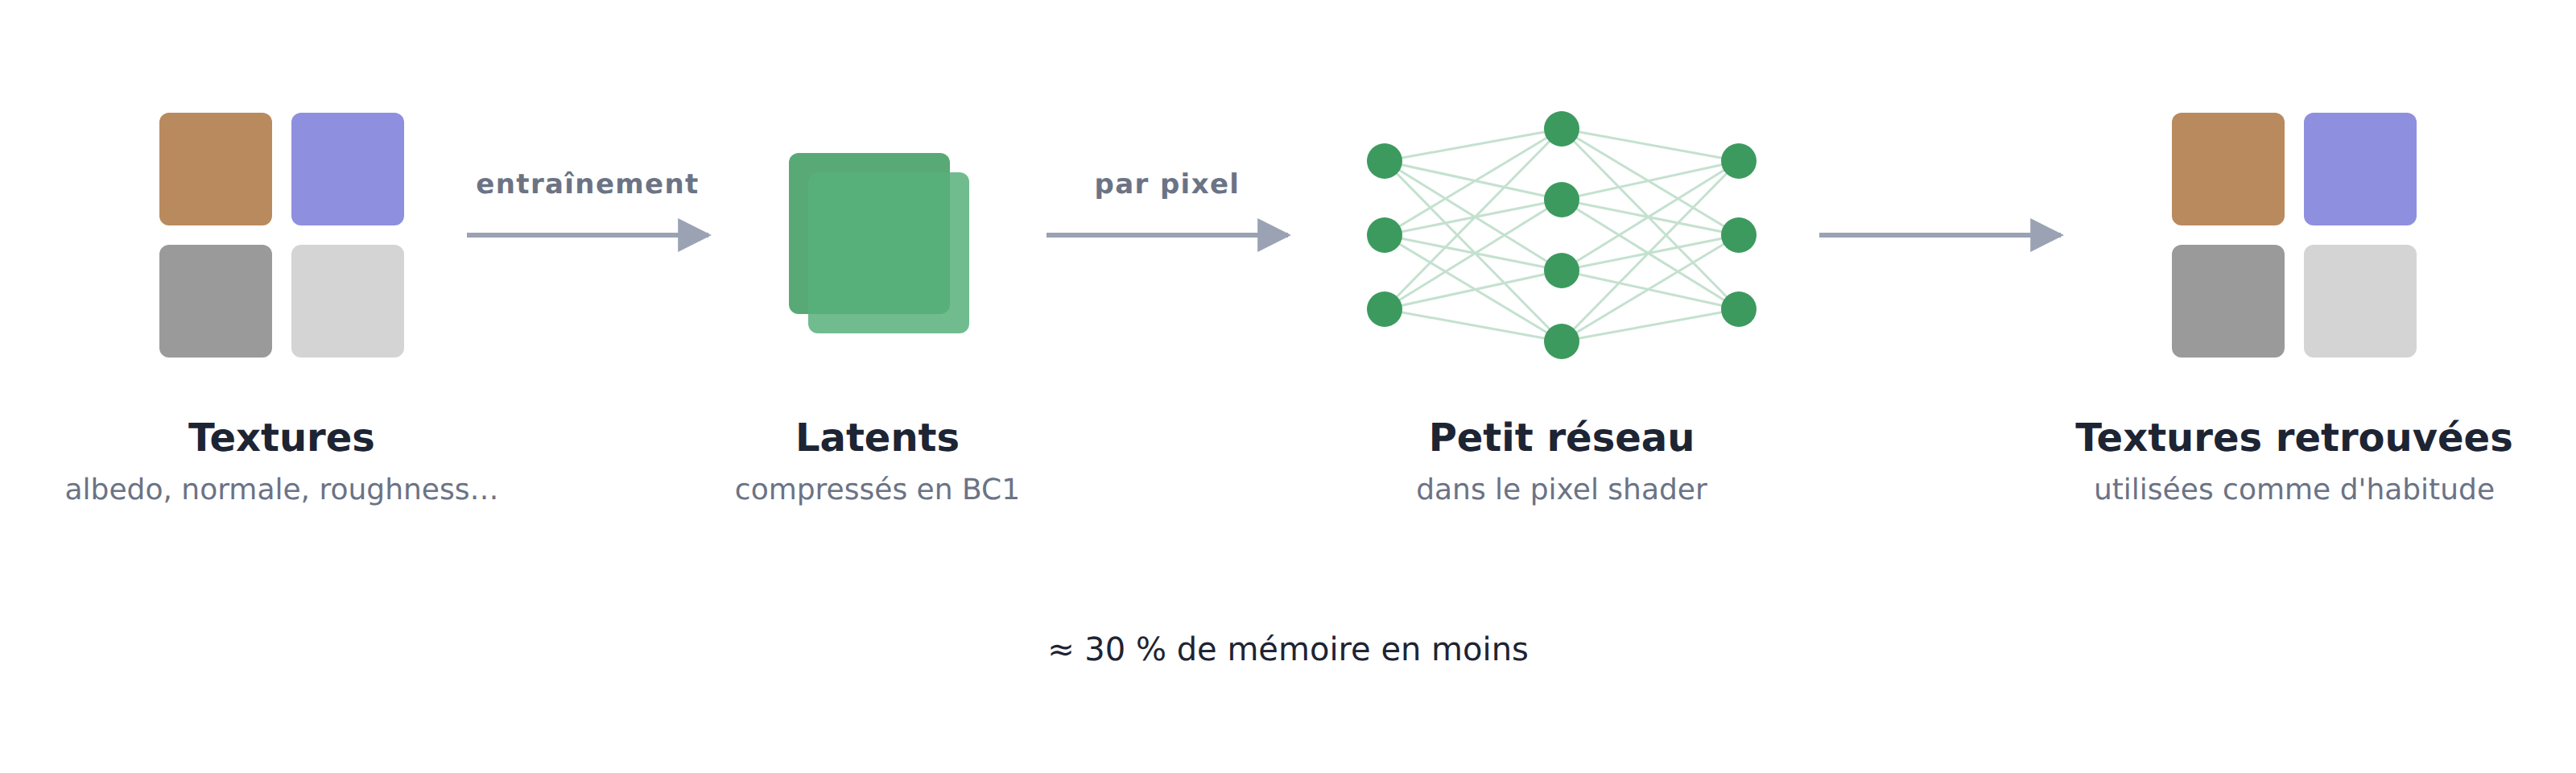
| Février 2026 | Ubisoft confirme avoir livré la neural texture compression dans Assassin's Creed Mirage, sur une partie des textures, avec environ 30 % de mémoire en moins | Ubisoft La Forge |
Le cas d'Assassin's Creed Mirage est intéressant parce qu'il stocke les textures sous forme de latents compressés, et un MLP avec une seule couche cachée les décode dans le pixel shader, pour chaque pixel. Ubisoft ne l'a appliqué qu'aux objets les plus répétés et les plus gourmands en mémoire, parce que le décodage a un coût à chaque frame.
À quoi ça sert concrètement
- Réduire la mémoire des textures. C'est l'usage le plus avancé en production, avec Mirage. Moins de VRAM, et un jeu plus léger à télécharger.
- Afficher en temps réel des matériaux qu'on ne sait rendre correctement qu'en offline. C'est le sujet des neural materials de NVIDIA et d'Ubisoft.
- Mieux calculer l'éclairage indirect quand on fait du path tracing en temps réel. C'est le rôle du neural radiance cache.
- Reproduire un effet physique trop coûteux à calculer, comme la lumière qui traverse une matière translucide.
Pourquoi ça bouge en 2026
L'idée existe depuis quelques années dans la recherche. Ce qui change en 2026, c'est que les API graphiques commencent à la supporter officiellement.
Les API suivent
Jusqu'ici, un réseau dans un shader s'écrivait à la main, avec des boucles et des multiplications classiques. DirectX a d'abord proposé les cooperative vectors en preview, prévus pour le Shader Model 6.9, puis les a remplacés par l'API Linear Algebra du Shader Model 6.10 (preview en avril 2026). Ces API permettent à un shader d'envoyer ces calculs aux tensor cores de la carte graphique (présentation GDC 2026, annonce DirectX). Vulkan a une extension équivalente chez NVIDIA.
Les limites aujourd'hui
En dehors de l'upscaling, les usages en production restent rares. Mirage et les mods RTX Remix sont les seuls exemples publics que j'ai trouvés (AMD annonce aussi un radiance cache neuronal dans FSR Redstone, réservé aux RX 9000). Le support matériel est encore inégal (toutes les RTX chez NVIDIA, seulement les RX 9000 chez AMD et les Arc B chez Intel, souvent encore en preview), donc les studios doivent garder un rendu classique en parallèle. Côté web, Chrome expérimente une extension WebGPU (subgroup matrix) qui donne accès à ces unités, mais elle est encore à l'état de brouillon, désactivée par défaut, réservée aux compute shaders et pensée pour multiplier des matrices entières, pas pour un petit réseau évalué pixel par pixel. WebGL, lui, n'y a pas accès.
C'est pour ça que j'ai fait sans, avec un réseau assez petit pour tourner en GLSL ordinaire, sur n'importe quel GPU. Le but n'était donc pas de suivre la tendance, mais de voir ce que ça donne concrètement dans un navigateur, et si c'est utilisable en prod sur les machines des utilisateurs ou pas.
Premier essai, une bougie
J'ai commencé par une bougie générée procéduralement, avec la lumière de la flamme qui traverse la cire. Ça fonctionnait, mais visuellement ce n'était pas terrible : le maillage de la bougie était trop simple pour obtenir un rendu de qualité, et l'effet calculé par le réseau était trop discret pour qu'on le remarque.
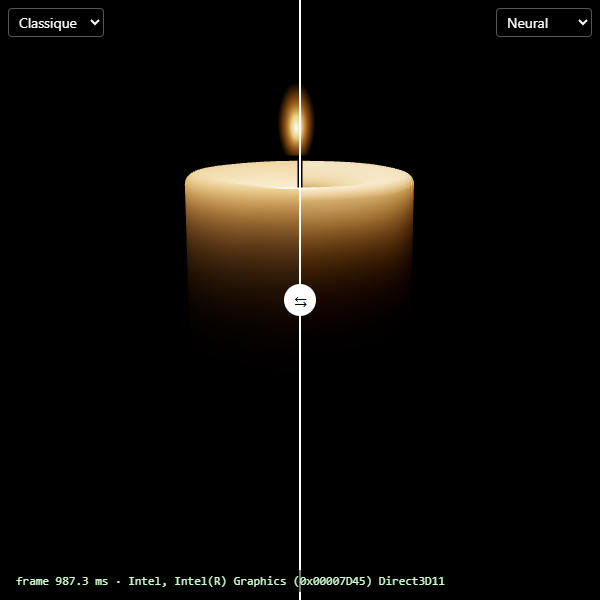
Le premier essai. La lumière dans la cire est juste, mais la scène est trop simple.
J'en ai retenu que l'effet calculé par le réseau doit être ce qu'on regarde en premier, d'où le choix d'un objet translucide avec des parties fines, éclairé à contre-jour.
Le test, un dragon de jade dans le navigateur
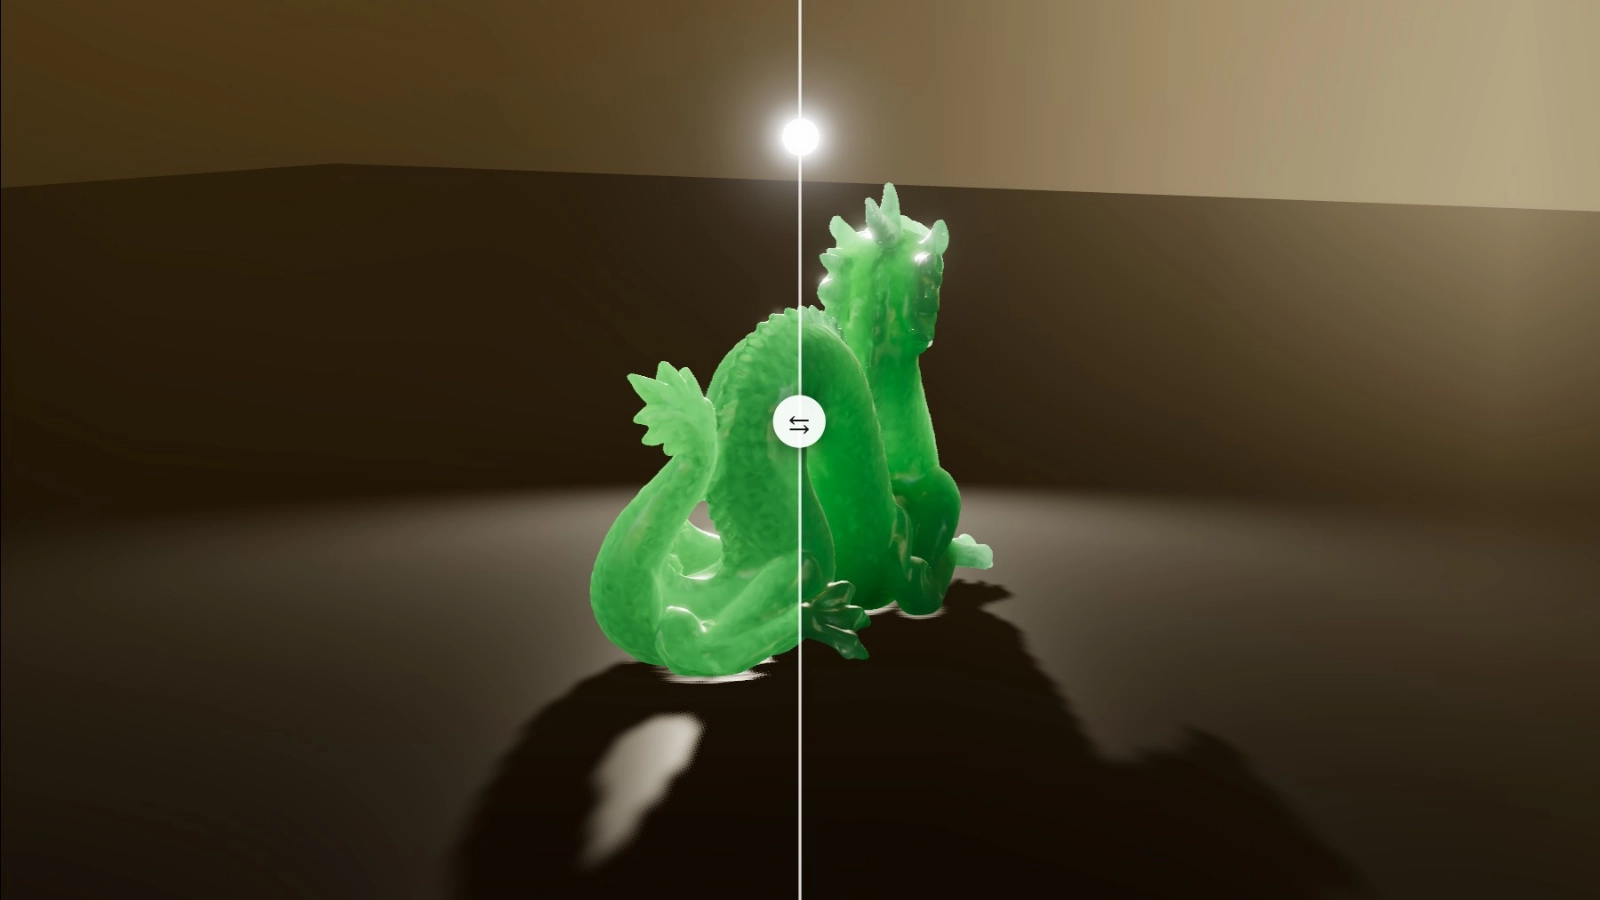
La démo affiche le dragon de Stanford en jade, éclairé par une vraie pièce (une HDRI) et par une lampe qu'on peut déplacer. Un rideau/slider permet de comparer deux à deux l'approximation classique, le réseau de neurones et le rendu path tracé.
Essayez la démo
Déplacez la lampe, comparez les rendus. La démo tourne dans votre navigateur, même sur téléphone. Ouvrir la démo
Prenez le dragon à contre-jour. La lumière de la lampe entre dans le jade, se diffuse dans la matière et ressort de l'autre côté. C'est ce qui donne ce vert profond aux parties fines, la queue, les pattes, la crête du dos. L'approximation classique estime l'épaisseur de l'objet en chaque point et en déduit combien de lumière passe. En lumière de face, le résultat est à peu près juste, mais à contre-jour l'erreur devient plus grande que la lumière elle-même.
Seule cette lumière qui traverse le jade change d'un côté du rideau à l'autre. Le vernis, les reflets, les ombres et le bloom restent ceux de three.js, identiques des deux côtés. Si l'image change, c'est donc le réseau qui en est responsable, et rien d'autre.
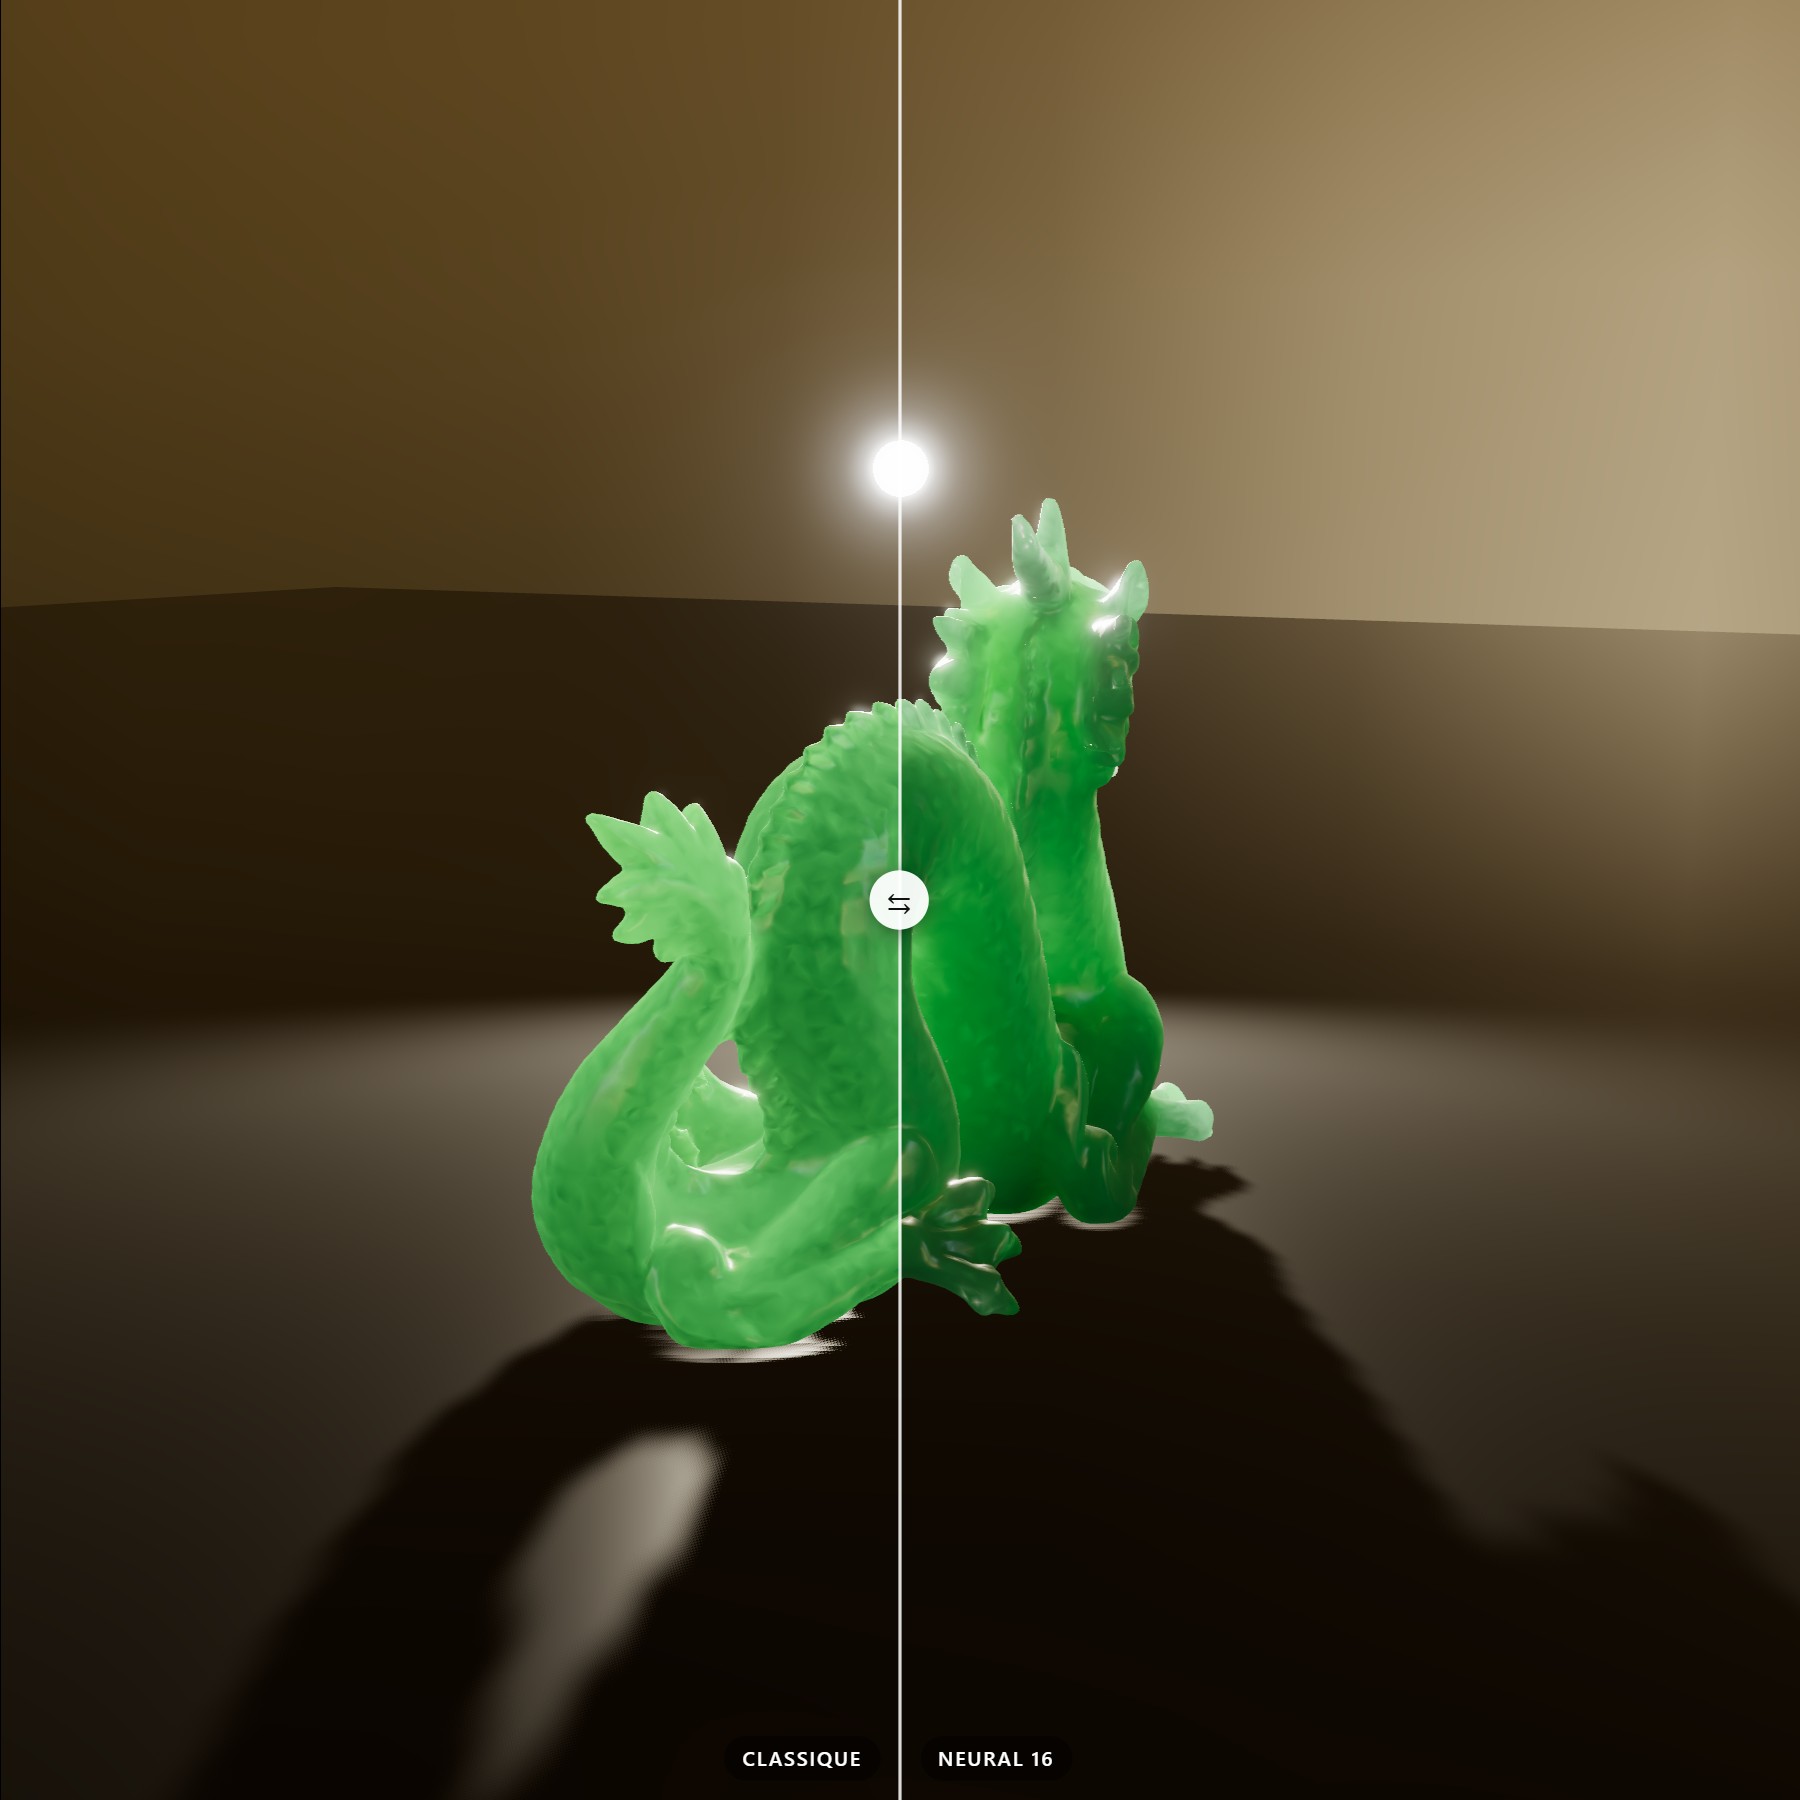
À contre-jour, l'approximation classique (à gauche) reste pâle et laiteuse. Le réseau (à droite) retrouve le vert profond du jade.
La ground truth
Les images de référence viennent de Mitsuba 3, un path tracer utilisé dans la recherche. Je lui ai fait rendre 400 vues du dragon, avec des angles de caméra et des positions de lampe tirés au hasard. Au total, ça donne 2,7 millions de points de la surface pour lesquels on connaît la lumière exacte. Le calcul a pris 2 h 40 sur le CPU (14 cœurs, pas de GPU).
Le réseau, 16 neurones et des latents par vertex
Un petit réseau seul ne peut pas savoir où le dragon est fin et où il est épais. La forme est trop complexe pour qu'il le devine à partir d'une simple position. J'ai donc ajouté 8 valeurs par vertex, qu'on appelle des latents. Elles sont apprises en même temps que le réseau et résument comment la lumière se comporte à cet endroit du mesh.
Dans le shader, ces latents sont des attributs de vertex comme les autres, et le GPU les interpole entre les sommets. Le réseau les reçoit avec la direction de la caméra et celle de la lampe, et calcule la lumière. L'entraînement prend 5 minutes sur CPU pour les trois tailles de réseau testées (16, 32 et 64 neurones).
Un premier rendu froissé
Ma première version avait un défaut visible dès qu'on la mettait à côté du path tracing : la surface du dragon avait l'air froissée, comme du papier d'aluminium, alors que la référence est lisse et laiteuse.
En regardant les latents, la cause était simple. Chaque sommet apprenait ses 8 valeurs tout seul, à partir d'une cinquantaine d'échantillons, eux-mêmes un peu bruités par le path tracer. Rien n'obligeait deux sommets voisins à se ressembler, donc les latents avaient appris ce bruit. 9 % des sommets n'étaient même vus par aucune caméra et gardaient une valeur au hasard. Le réseau recevait aussi la normale brute du scan, avec toutes ses petites bosses, alors que dans le jade la lumière se diffuse sur quelques millimètres et les efface.
Deux corrections ont suffi, sans toucher aux données d'entraînement :
- pendant l'entraînement, une pénalité oblige les sommets voisins à avoir des latents proches ;
- le réseau reçoit une normale lissée sur les sommets voisins, au lieu de la normale brute.
La surface est redevenue lisse, et l'erreur du réseau 16 est passée de 0,39 à 0,35 (de 0,58 à 0,50 à contre-jour). Là encore, c'est la comparaison avec la référence qui m'a montré le problème.
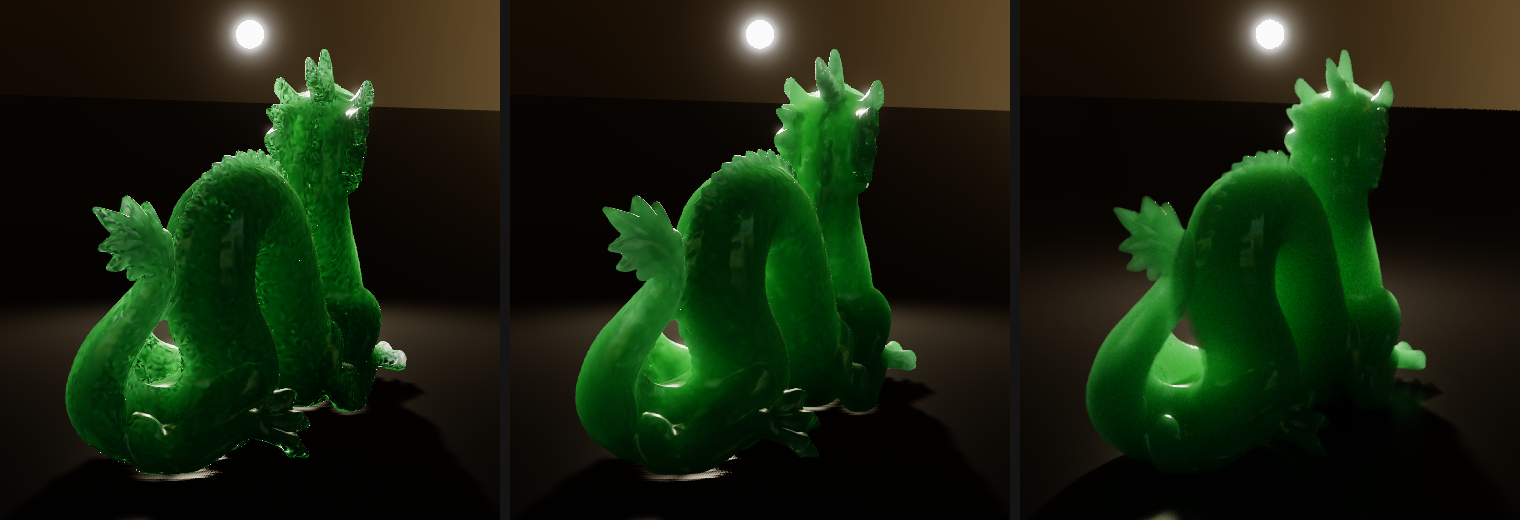
À contre-jour, de gauche à droite : le réseau avant la correction, après, et la référence path tracée.
Les résultats
Pour comparer, j'ai calculé 4 images de référence avec Mitsuba, dont 2 à contre-jour, puis j'ai mesuré à quel point chaque méthode s'en éloigne. Le chiffre ci-dessous est l'erreur moyenne, rapportée à la luminosité moyenne de l'image. 0 veut dire identique à la référence. 1 veut dire que l'erreur est aussi grande que la lumière elle-même.
| Méthode | Erreur moyenne | Erreur à contre-jour |
|---|---|---|
| Approximation classique (épaisseur par vertex), réglée sur les mêmes données | 1,04 | 1,69 |
| Réseau 16 neurones | 0,35 | 0,50 |
| Réseau 32 neurones | 0,37 | 0,56 |
| Réseau 64 neurones | 0,42 | 0,68 |
Concrètement, le réseau fait environ 3 fois moins d'erreur que l'approximation classique. L'écart est le plus net à contre-jour, justement là où l'approximation classique a du mal. Autre surprise, un réseau plus gros ne fait pas mieux : le 32 et le 64 collent davantage aux vues d'entraînement, mais se trompent plus sur des poses qu'ils n'ont jamais vues. Ce sont surtout les latents qui portent l'information. La démo utilise donc le réseau 16, le plus léger et le plus juste.
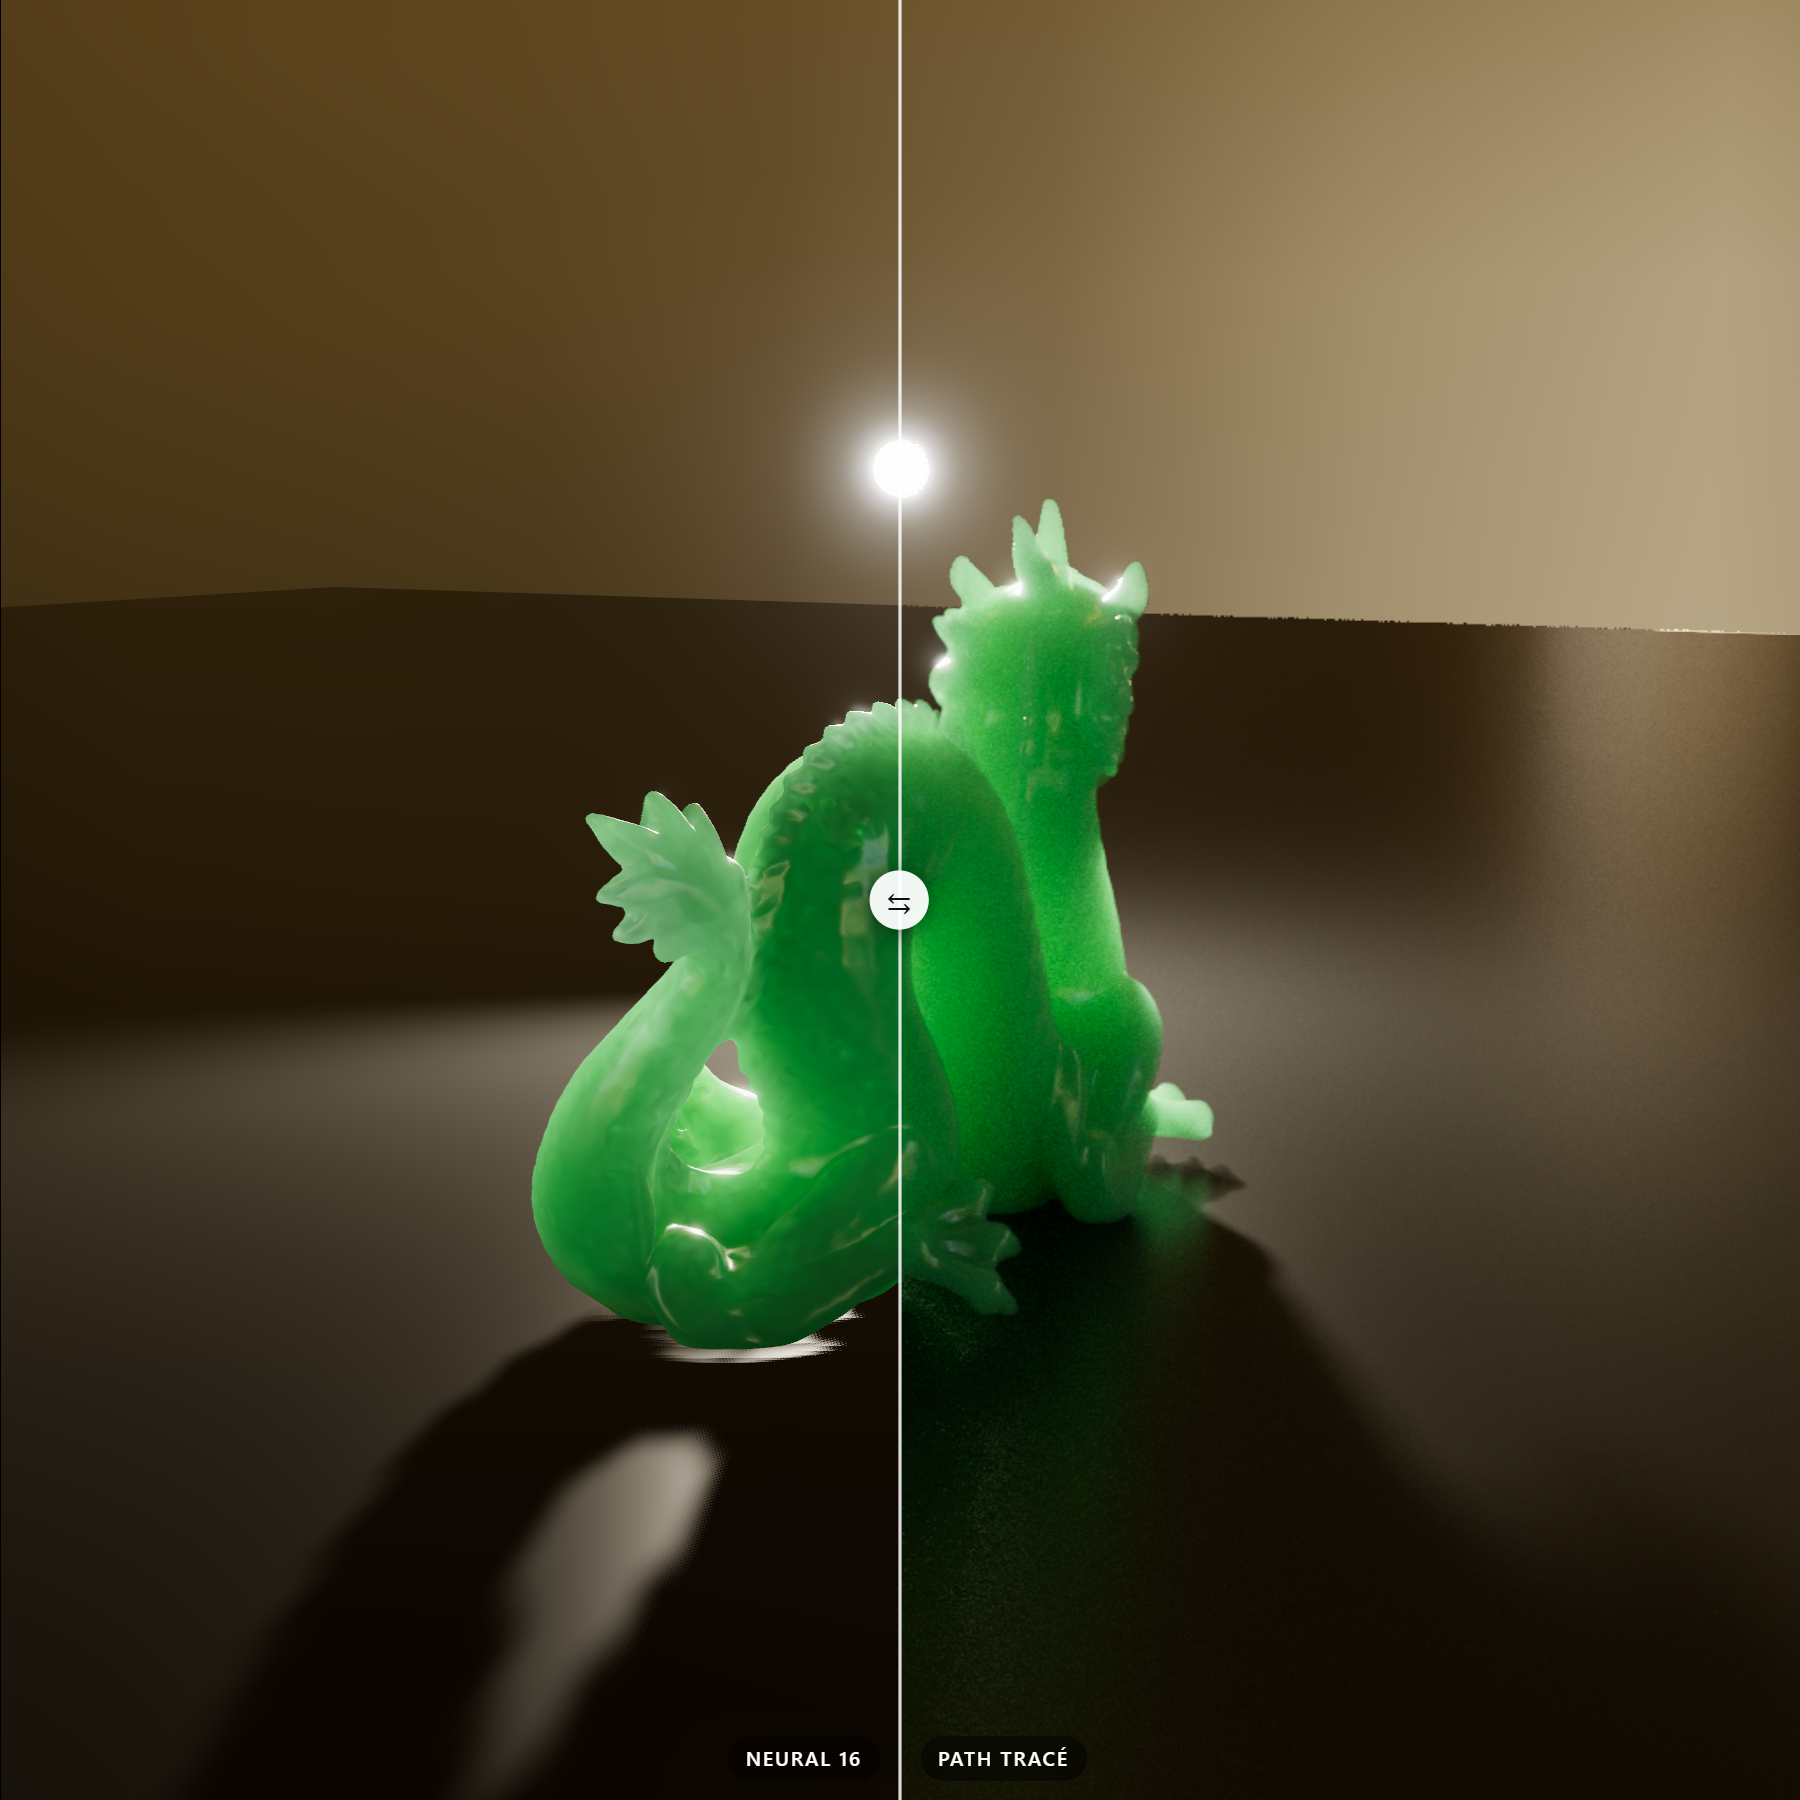
Le réseau de 16 neurones à gauche, le rendu path tracé à droite (environ 15 minutes de calcul pour cette seule image).
Côté téléchargement, voici ce que charge la page (fichiers compressés).
| Fichier | Poids |
|---|---|
| HDRI de la pièce | 1,36 Mo |
| Mesh du dragon (80 000 triangles) | 1,34 Mo |
| Latents | 292 Ko |
| Normales lissées (pour le réseau) | 119 Ko |
| Épaisseur par vertex (pour l'approximation classique) | 38 Ko |
| Poids du réseau 16 | 8 Ko |
| Total au démarrage | 3,2 Mo |
Les poids du réseau pèsent moins qu'une icône. Le gros du poids, ce sont le mesh et l'HDRI, comme dans n'importe quelle scène 3D.
Côté performances, le bouton "Mesurer" de la démo donne le temps d'une image complète, bloom compris. Pour tenir 60 fps, il faut rester sous 16,7 ms.
| Appareil | Approximation classique | Réseau 16 | Réseau 32 | Réseau 64 |
|---|---|---|---|---|
| PC portable (GPU intégré) | 25 ms (40 fps) | 29 ms (34 fps) | 41 ms (24 fps) | 92 ms (11 fps) |
| Pixel 6a | 26 ms (38 fps) | 34 ms (29 fps) | 61 ms (16 fps) | 316 ms (3 fps) |
Mon PC est un portable pro sans carte graphique dédiée : même sans le réseau, il ne tient pas les 60 fps, à cause du halo (le bloom). Le réseau 16 n'ajoute qu'environ 4 ms, pour une meilleure qualité que le 32 : c'est le bon choix. Sur le Pixel 6a, le 16 reste jouable, le 32 tombe à 16 fps et le 64 est inutilisable.
Là, j'ai eu un résultat bien plus convaincant. Il reste des défauts, surtout à contre-jour où le jade est un peu trop saturé, mais j'ai senti un vrai potentiel sur les effets qui demandent beaucoup de calcul.
À retenir
- Sans images de référence, on ne peut pas savoir si le réseau a raison, ni repérer ses propres bugs.
- Le réseau est entraîné pour ce dragon, cette pièce et cette lampe. Pour un autre objet, il faut tout réentraîner.
Le reproduire chez vous
Le pipeline tient en cinq étapes : les trois premières tournent une seule fois, hors ligne, puis le navigateur ne fait que rejouer le réseau.
Code source
Le code complet de la démo est sur GitHub
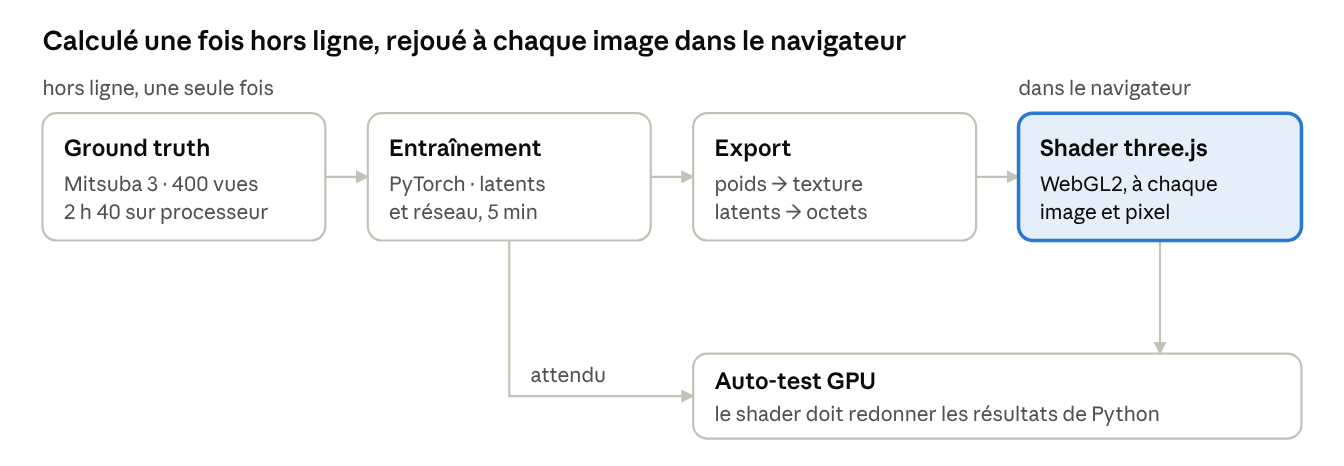
1. Générer la ground truth
Rendez votre objet avec un path tracer, sous beaucoup d'angles et d'éclairages différents. Pour chaque pixel, gardez la lumière, mais aussi tout ce que le shader aura sous la main au moment du rendu, c'est-à-dire la position, la normale et le triangle touché. Mitsuba sait sortir tout ça sous forme d'AOV.
Deux conseils tirés de mes erreurs. Séparez les sources de lumière dans des passes distinctes (j'ai rendu la pièce et la lampe à part). Et plafonnez les fireflies avant d'entraîner.
2. Entraîner le réseau
Avec PyTorch, quelques minutes de CPU suffisent. En entrée, le réseau reçoit les latents interpolés et la géométrie (normale, direction de la caméra, angle entre la normale et la lampe, direction et distance de la lampe). En sortie, il donne six valeurs, la lumière venant de la pièce et celle venant de la lampe.
x = torch.cat([latents, normale, vue, dir_lampe, dist_lampe, n_dot_l], dim=1)
for couche in couches_cachees:
    x = torch.relu(couche(x)) ** 2
lumiere = torch.exp(torch.minimum(sortie(x), plafond))
Le relu au carré, plutôt qu'un relu simple, évite des cassures visibles dans l'image.
Deux garde-fous évitent un rendu froissé : une pénalité qui force les latents de sommets voisins à se ressembler, et une normale lissée en entrée plutôt que la normale brute du mesh.
3. Exporter les poids dans une texture
Rangez tous les poids dans une texture float RGBA32F, quatre valeurs par pixel. C'est plus robuste que de les écrire en dur dans le shader.
4. Évaluer le réseau dans le shader
Côté three.js, le fragment shader lit les poids quatre par quatre et enchaîne des produits scalaires. C'est du GLSL tout ce qu'il y a de plus classique, compatible WebGL2.
for (int j = 0; j < 16; j++) {
  float s = biais(j);
  for (int v = 0; v < 5; v++) s += dot(poids(ligne + j * 5 + v), entree[v]);
  float r = max(s, 0.0);
  cachee[j / 4] += canal(j) * (r * r);
}
J'injecte le résultat comme lumière émise dans un MeshPhysicalMaterial et three.js continue de gérer les reflets, les ombres et le bloom.
Et après ?
Le jade n'est qu'un exemple. Le même pipeline (une ground truth, un petit réseau, un shader) s'applique à d'autres effets que le temps réel gère mal. Voici ceux qui me paraissent les plus intéressants pour de la 3D sur le web.
Des tissus et des matières qui changent avec l'angle
Un velours, une bouclette ou un cuir patiné ne renvoient pas la lumière de la même façon selon l'angle de vue. On sait les mesurer ou les rendre en offline, mais en temps réel on se contente d'un PBR standard. Avec des latents stockés dans une texture plutôt que par vertex, un petit réseau peut restituer ce comportement. C'est l'approche des neural materials de NVIDIA et d'Ubisoft, et sur un configurateur de meubles, un canapé en velours vu de biais ferait la différence.
L'éclairage d'une pièce selon l'heure
Aujourd'hui, pour montrer une pièce le matin et le soir, il faut précalculer une lightmap par moment de la journée. Un réseau qui reçoit la position sur la surface et la direction du soleil peut remplacer toutes ces lightmaps par une seule fonction continue. On déplace un slider, et le soleil traverse la pièce avec un éclairage indirect calculé par un path tracer.
Des textures plus légères à télécharger
Mirage gagne environ 30 % de mémoire sur ses textures. Sur le web, le vrai coût, c'est le téléchargement des jeux de textures PBR (albedo, normal map, roughness), surtout sur mobile. Des latents compressés et un petit décodeur dans le shader pourraient alléger un catalogue de matériaux.
D'autres pistes
- Les matériaux en couches, comme un bois laqué où la lumière rebondit entre la laque et le bois. Un configurateur de cuisine en est plein.
- Le verre et les liquides, avec la réfraction et les caustiques d'une bouteille ou d'un flacon.
- L'ambient occlusion apprise, calculée en screen space.
- La fumée, la brume et les nuages.
J'ai aussi testé l'AO et le verre
J'ai voulu vérifier deux de ces pistes avec le même pipeline, sous forme de tests rapides. Les résultats sont comparables avec le même rideau sur la page Labo de la démo.
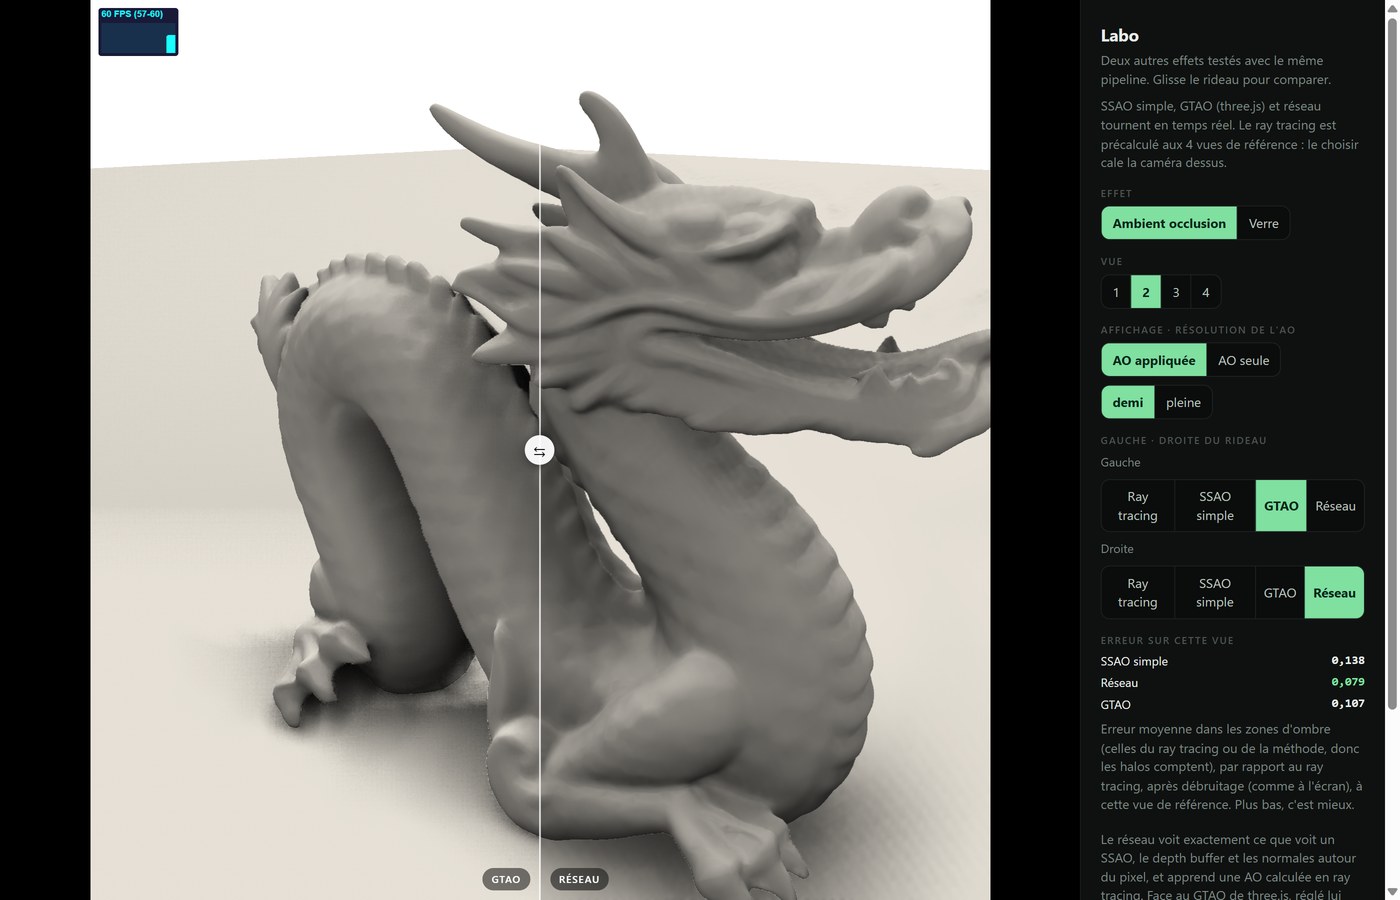
La page Labo. Chaque côté du rideau affiche une méthode, et le panneau donne l'erreur de chacune par rapport à la référence.
L'ambient occlusion. Le réseau reçoit les mêmes infos qu'un SSAO (profondeur et normales autour du pixel) et apprend à imiter une AO calculée en ray tracing. Pour un rendu propre, il a fallu ajouter les deux astuces classiques des SSAO : un motif d'échantillons qui tourne d'un pixel à l'autre, et un flou qui respecte les bords.
Je l'ai comparé au GTAO de three.js, la technique des moteurs actuels, avec ses meilleurs réglages. Je compte aussi l'ombre qu'une méthode invente, car le défaut du GTAO, c'est un halo gris autour du dragon.
Le réseau fait 28 % d'erreur en moins que le meilleur GTAO (0,08 contre 0,11) (ici une erreur absolue moyenne sur les pixels sombres, à ne pas comparer aux chiffres du jade) et gagne sur les quatre vues. Mais il coûte plus cher (12 ms contre 10 ms sur PC, deux fois plus sur le Pixel 6a), et aucune méthode ne capte bien l'ombre de contact sous le dragon.
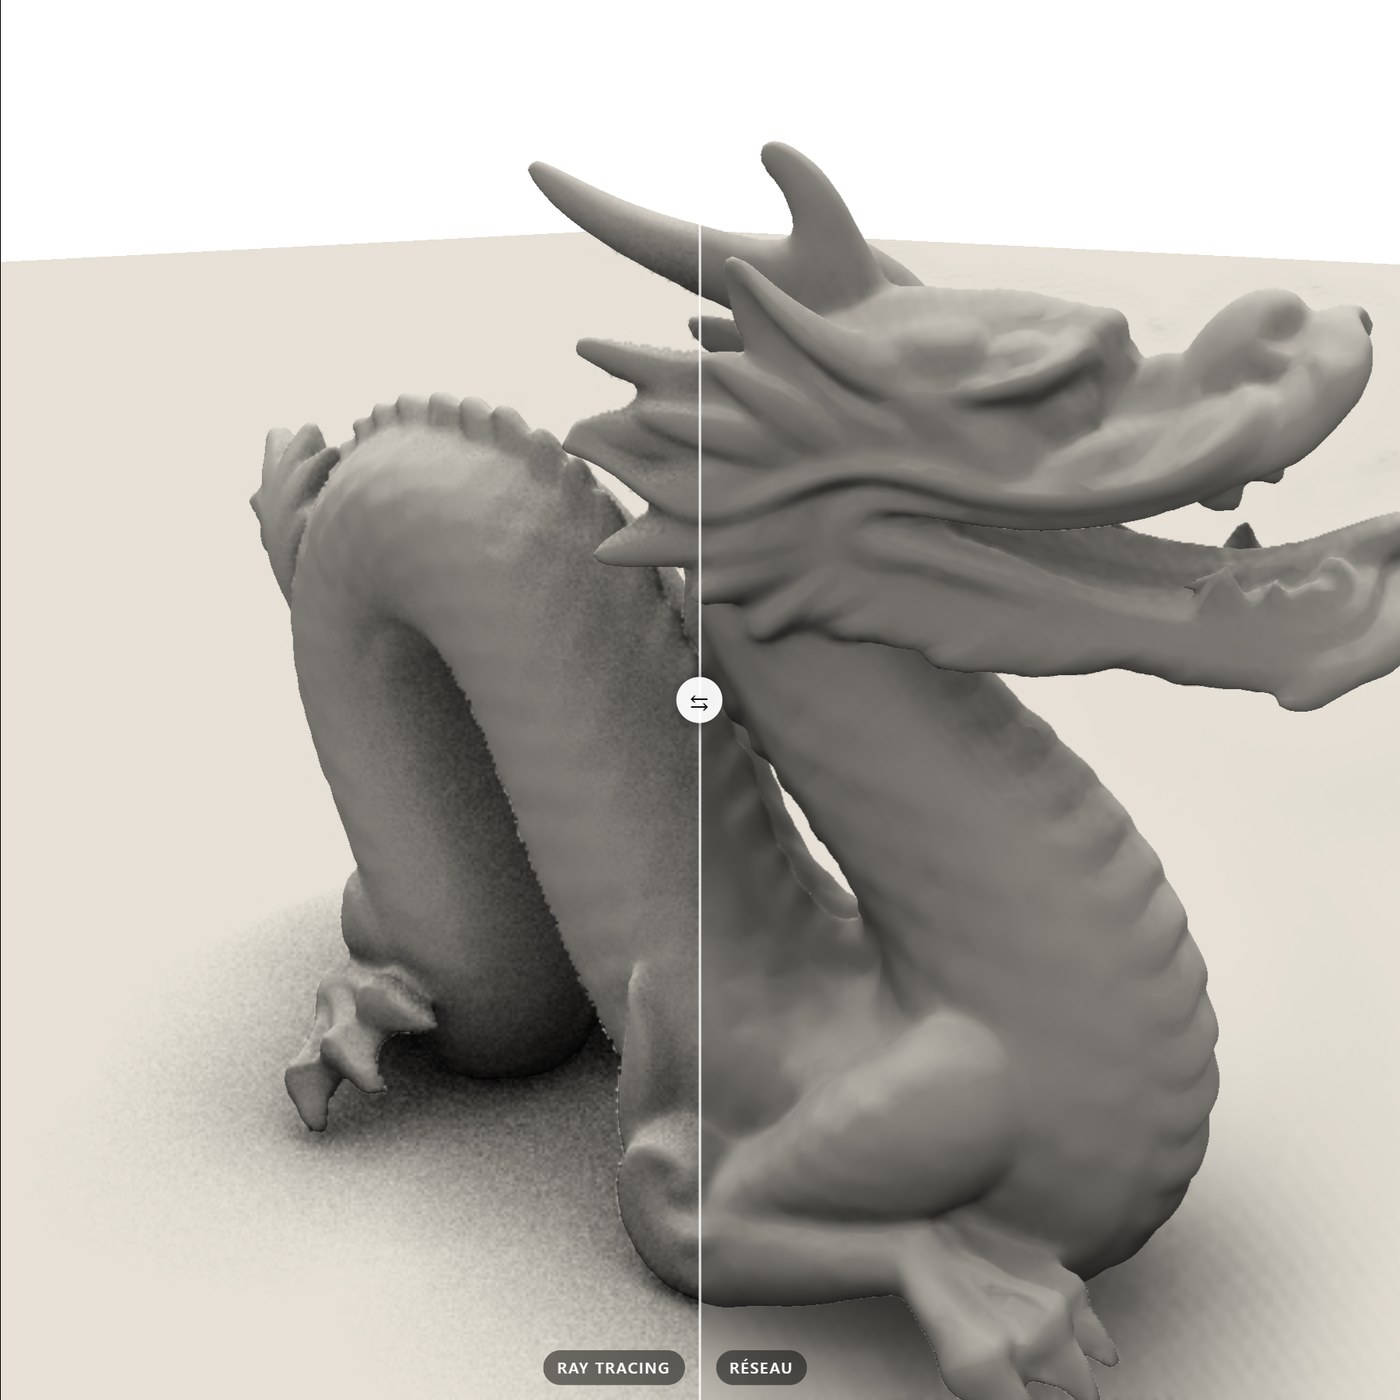
Ambient occlusion en temps réel, appliquée sur un rendu argile. Ray tracing précalculé à gauche, réseau à droite.
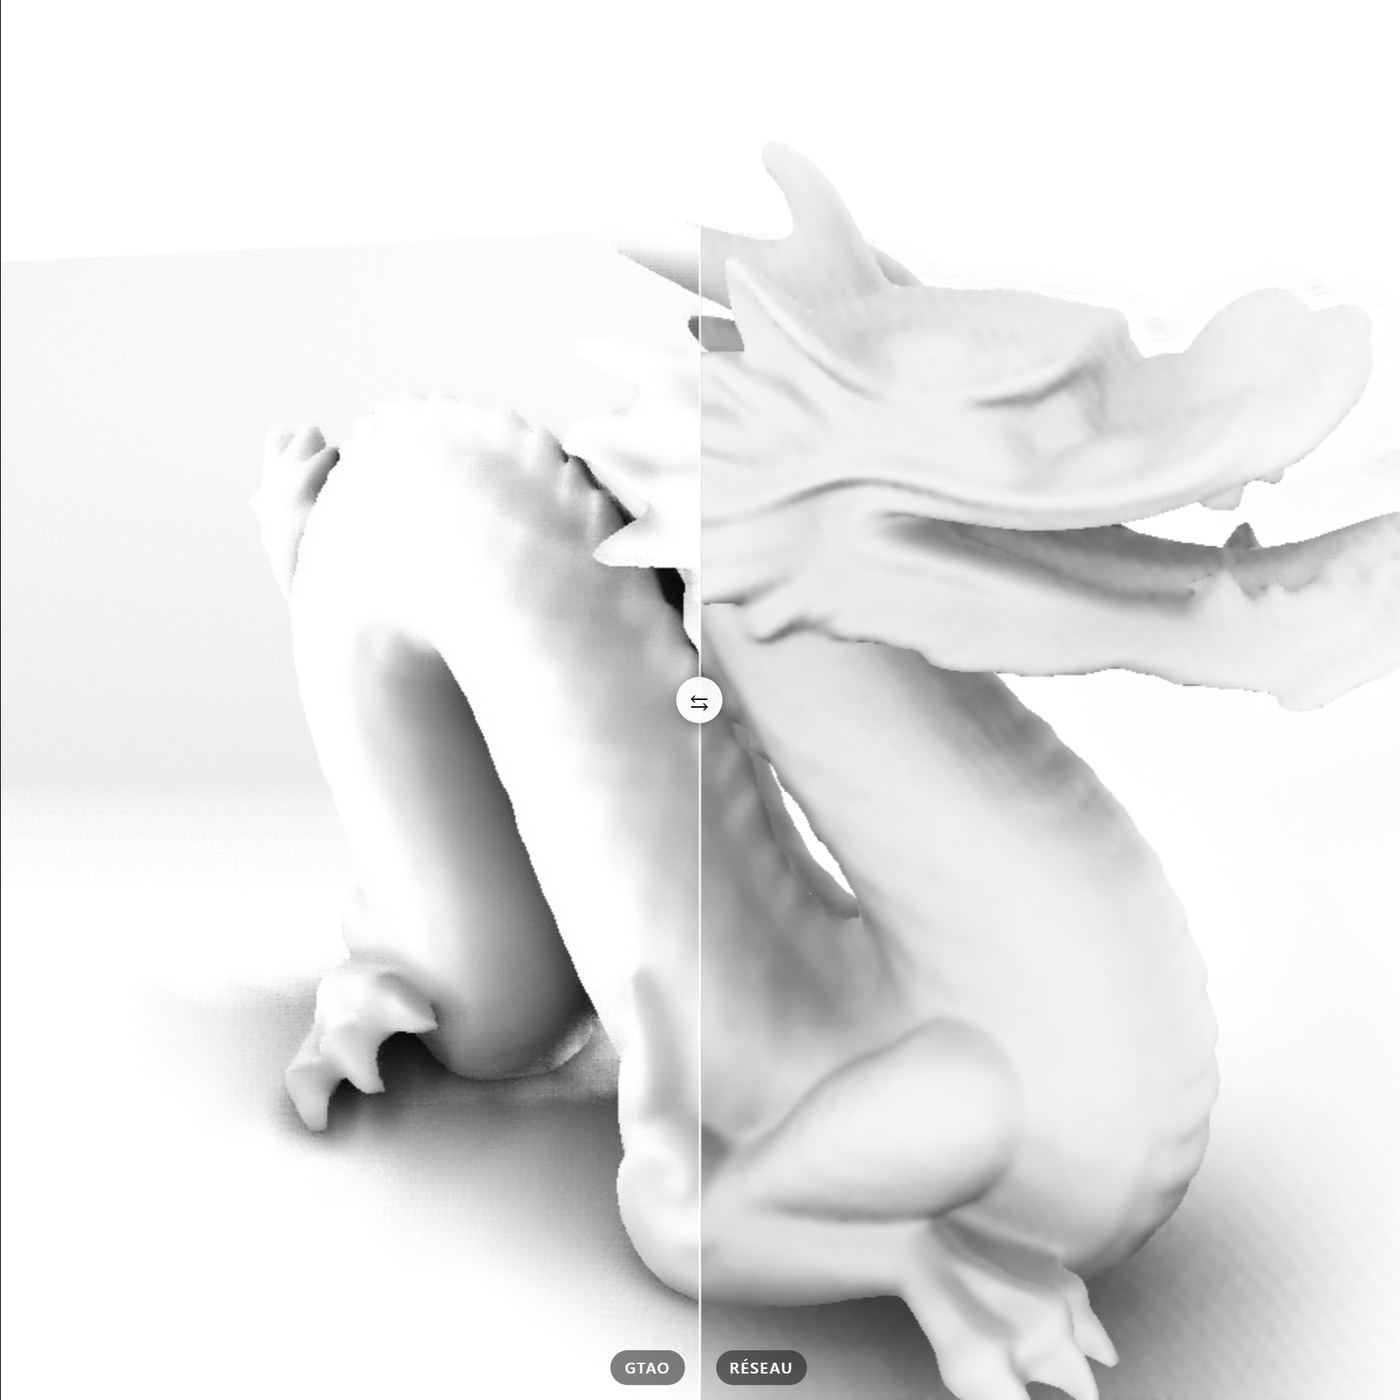
L'AO seule, sans l'argile. Le GTAO (à gauche) grise le sol et le fond autour du dragon. Le réseau (à droite) garde le clair là où rien ne cache la lumière.
Le verre. Le réseau devait apprendre où la lumière ressort après avoir traversé un dragon en verre. Là, ça ne marche pas : le rendu est granuleux et même un peu moins bon que la réfraction simple (1,13 d'erreur contre 1,09), alors que le vrai trajet de la lumière fait bien mieux (0,74).
Dans le verre, deux pixels voisins peuvent ressortir dans des directions opposées, alors que les latents interpolés ne donnent qu'un résultat lisse. Ça reste parfait pour le jade, mais pas pour le verre.
J'ai donc essayé l'inverse : le shader calcule le vrai trajet de chaque rayon dans le mesh (jusqu'à 8 réflexions internes), grâce à three-mesh-bvh. Les deux versions tournent en direct sur la page Labo.
Le rendu est enfin juste, mais lent : 4 images par seconde sur mon PC portable (16 pour le réseau, plus de 100 pour la réfraction simple), moins de 3 sur le Pixel 6a.
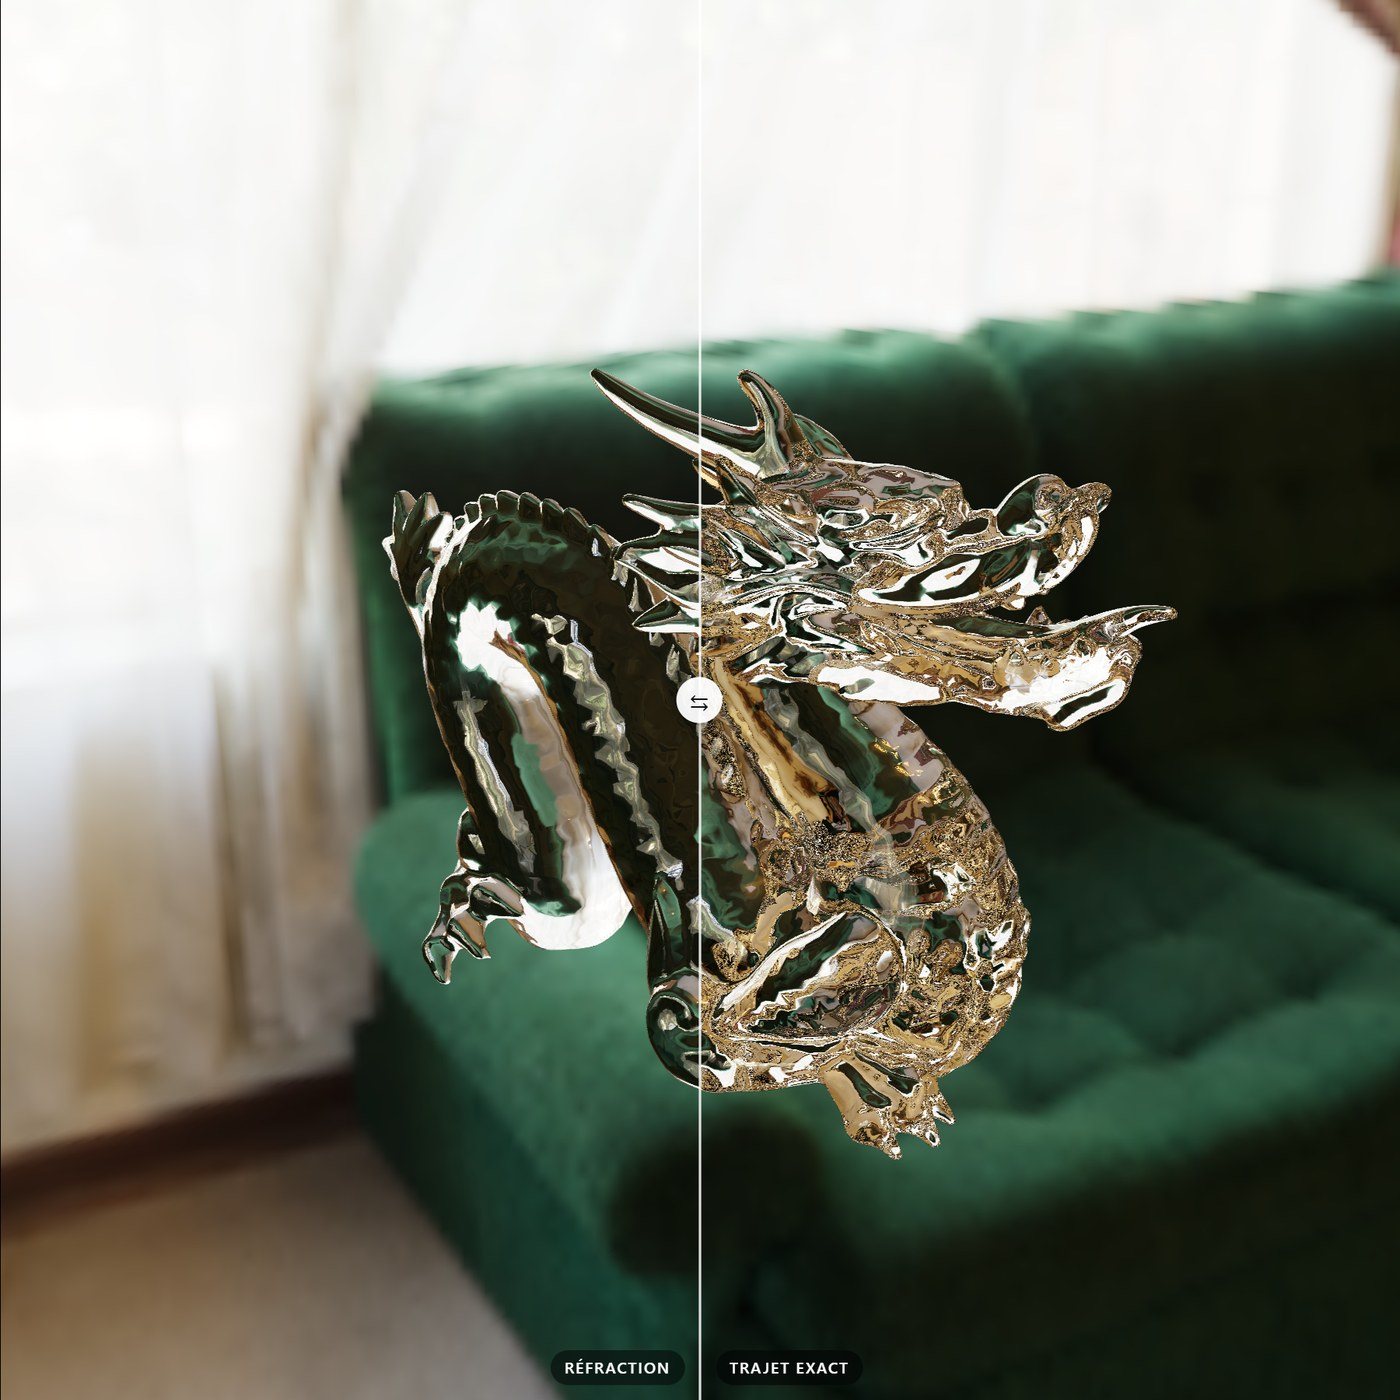
En direct dans le navigateur. La réfraction simple (à gauche) donne un verre sombre et plat. Le trajet exact (à droite), avec ses réflexions internes, ressemble enfin à du verre.
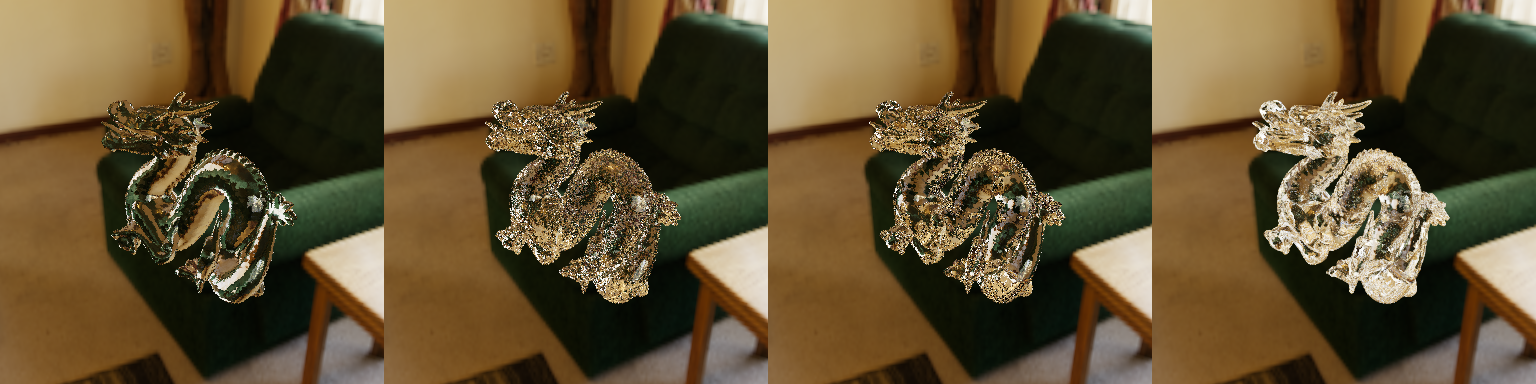
Dragon en verre. De gauche à droite, la réfraction simple, le réseau, le vrai trajet de la lumière et la référence Mitsuba.
Pour moi, c'est la vraie leçon de ces tests : le neural shading marche bien sur des effets qui varient doucement, et beaucoup moins sur des effets qui changent brutalement d'un pixel à l'autre.
Mon verdict
Oui, le neural shading fonctionne dans une page web, sans matériel particulier. Un réseau de 16 neurones en GLSL, 8 Ko de poids, et sur un effet que les techniques classiques simulent mal, comme la lumière dans le jade, la différence se voit à l'œil nu. Le réseau 16 ajoute environ 4 ms par image sur mon PC portable, et la démo reste jouable sur le Pixel 6a, autour de 30 fps.
Par contre, ce n'est pas magique : le réseau est entraîné pour un objet, un éclairage et une matière. Il faut des images de référence, des heures de calcul, et vérifier ses résultats bien plus que pour un shader classique. Sur un configurateur avec des milliers de produits, ça représente un vrai coût de production.
Est-ce que je l'utiliserais en production ? Oui, mais vraiment pour un client qui demande quelque chose de très spécifique.
Ce sujet vous intéresse ?
Chez WanadevDigital, on conçoit des configurateurs 3D dans le navigateur depuis 2009. Si vous cherchez à améliorer le rendu de vos produits en ligne, discutons de votre projet.
Sources
- Charles Grassi, Neural volumetric clouds
- Microsoft, DirectX Raytracing 1.2, PIX, Neural Rendering (GDC 2025)
- Microsoft, Shader Model 6.9 and the future of Cooperative Vector
- Microsoft, D3D12 Linear Algebra preview
- Windows Report, Neural Rendering et DXR 2.0 à la GDC 2026
- TweakTown, RTX Kit 2026.3 et Neural Texture Compression
- Igor's Lab, AMD FSR Redstone en détail
- NVIDIA, Real-Time Neural Appearance Models
- Stanford Computer Graphics Laboratory, Stanford 3D Scanning Repository
- Poly Haven, HDRI "anniversary lounge" (CC0)
- Ubisoft La Forge, Shipping neural texture compression in Assassin's Creed Mirage (février 2026)
- Ubisoft La Forge, Real-Time Neural Materials with Block-Compressed Features (Eurographics 2024)
- NVIDIA, RTX Neural Rendering and Digital Human Technologies at GDC 2025
-
 Créez votre assistant personnel grâce à Gmail et ChatGPT 4
Il y a 3 ans
Les LLMs, ou Large Language Models, comme ChatGPT, Llama2, Claude ou encore Mistral nous donne un avant-goût du futur des assistants virtuels tels que nous les connaissons avec Google, Siri ou Alexa. Pourtant, il manque une sacrée touche personnelle avec ces assistants nouvelle génération. Même si OpenAI a mis en place un système permettant d’à peu près personnaliser son expérience avec ChatGPT, nous sommes loin d’avoir des IA qui nous connaissent réellement. La raison est assez simple : ceux-ci n’ont pas accès à vos données. Et si on aidait ces LLMs si puissant en leur donnant des données pour qu’ils sachent répondre à des requêtes très personnalisées ?
Lire la suite
Alexandre DAUBOIS
-
 Tests automatiques fonctionnels d’applications 2D/3D
Il y a 5 ans
Comme nous le disions dans cet article, l’automatisation des tests dans le développement logiciel est indispensable : dès lors qu’une application commence à avoir un minimum d’importance, les tests automatiques permettront de gagner énormément de temps en évitant de reproduire ad vitam æternam les mêmes tests manuels, et éviteront beaucoup de régressions. Dans cet article, nous allons présenter différents types de tests automatiques dans le cadre plus spécifique d’applications 2D/3D, puisque c’est ce que nous faisons ! Cela va du test basique qui clique sur 3 boutons aux tests de plusieurs minutes reproduisant les actions comme un véritable utilisateur. Accrochez-vous, c’est parti !
-
 Lambda : le juste prix !Recherche et développement
Il y a 6 ans
On a tous connu et on connaît encore des projets développés en un seul bloc d'une façon monolithique. C’est la structure classique d’un projet. En grossissant, il gagne en fonctionnalités et devient rapidement trop complexe, trop lourd, difficile à faire évoluer et surtout incapable à gérer des pics de charge. Pour éviter cela, un concept est apparu après les années 2000 : les microservices.
-
 Collaborer en réalité virtuelle : retour d'expérience et tour d'horizon des outils disponibles
Il y a 7 ans
En ces temps de télétravail et de confinement, pouvoir collaborer avec ses collègues le plus naturellement possible est un enjeu majeur pour être aussi efficace que possible et pour conserver le lien social fort qui nous relie tous chez Wanadev (les copains vous me manquez déjà !).
Lire la suite
Jean-Noel CHARLIER
-
 La culture de l'open source chez WanadevRecherche et développement
Il y a 7 ans
Chez Wanadev, l'utilisation et la contribution à l'écosystème open source est aujourd'hui une évidence, et ce n'est pas prêt de changer : c'est inscrit dans notre ADN. Dans cet article, et dans quelques autres qui vont suivre, je vais vous expliquer pourquoi et comment l'équipe contribue à l'open source, et quelle est notre culture d'entreprise à ce sujet.
-
Le meilleur cloud est celui qui n'existe pas encore !Recherche et développement
Il y a 7 ans
Ce n'est plus à démontrer, le monde actuel fonctionne en grande partie grâce à internet. En coulisses, de nombreux acteurs techniques fourmillent pour proposer des solutions adaptées à la forte croissance du marché et aux nouveaux usages. Entre eux, la concurrence fait rage et le cloud est le nouvel eldorado. Côté consommateur, l'offre paraît complexe et suscite souvent plus de questions que de réponses.